
万相-参考生视频模型支持多模态输入(文本、图片、视频、音频),可将人物或物体作为主角,根据提示词生成动作与音色一致的表演视频。
- 角色复刻:从参考图片或视频中复制角色外观。如果参考素材是视频,模型还能复刻语音音色。
- 多角色互动:最多支持五个角色同时出镜,实现自然对话和互动。
- 多镜头叙事:通过智能多镜头调度,保持角色在不同镜头间的一致性。
- 声音克隆(wan2.7):提供
reference_voice音频文件,可独立设置语音音色,不依赖参考视频中的声音。
支持的模型
| 模型 | 特性 | 输入 | 输出 |
|---|---|---|---|
wan2.7-r2v-2026-06-12 推荐 | 音频同步、多角色、声音克隆、首帧控制、media 数组输入 | 文本、图片、视频、音频 | 720P 或 1080P,2-15 秒,30 fps,MP4(H.264) |
| wan2.6-r2v-flash | 有声或无声视频、单人或多人、多镜头叙事、音画同步。速度快、性价比高。 | 文本、图片、视频 | 720P 或 1080P,2-10 秒,30 fps,MP4(H.264) |
| wan2.6-r2v | 有声视频、多角色参考视频生成、多镜头叙事、音画同步 | 文本、图片、视频 | 720P 或 1080P,2-10 秒,30 fps,MP4(H.264) |
前提条件
在千问AI平台获取千问AI平台 API Key,并设置为环境变量:
快速开始
输入提示词:视频1抱着图3,在图4的椅子上弹奏一支舒缓的乡村民谣,并说道:“今天的阳光真好。”图1手中拿着图2,路过视频1,把手中的图2放到视频1旁边的桌子上,并说道:“真好听,能不能再唱一遍”。
输入图像(图1)参考人物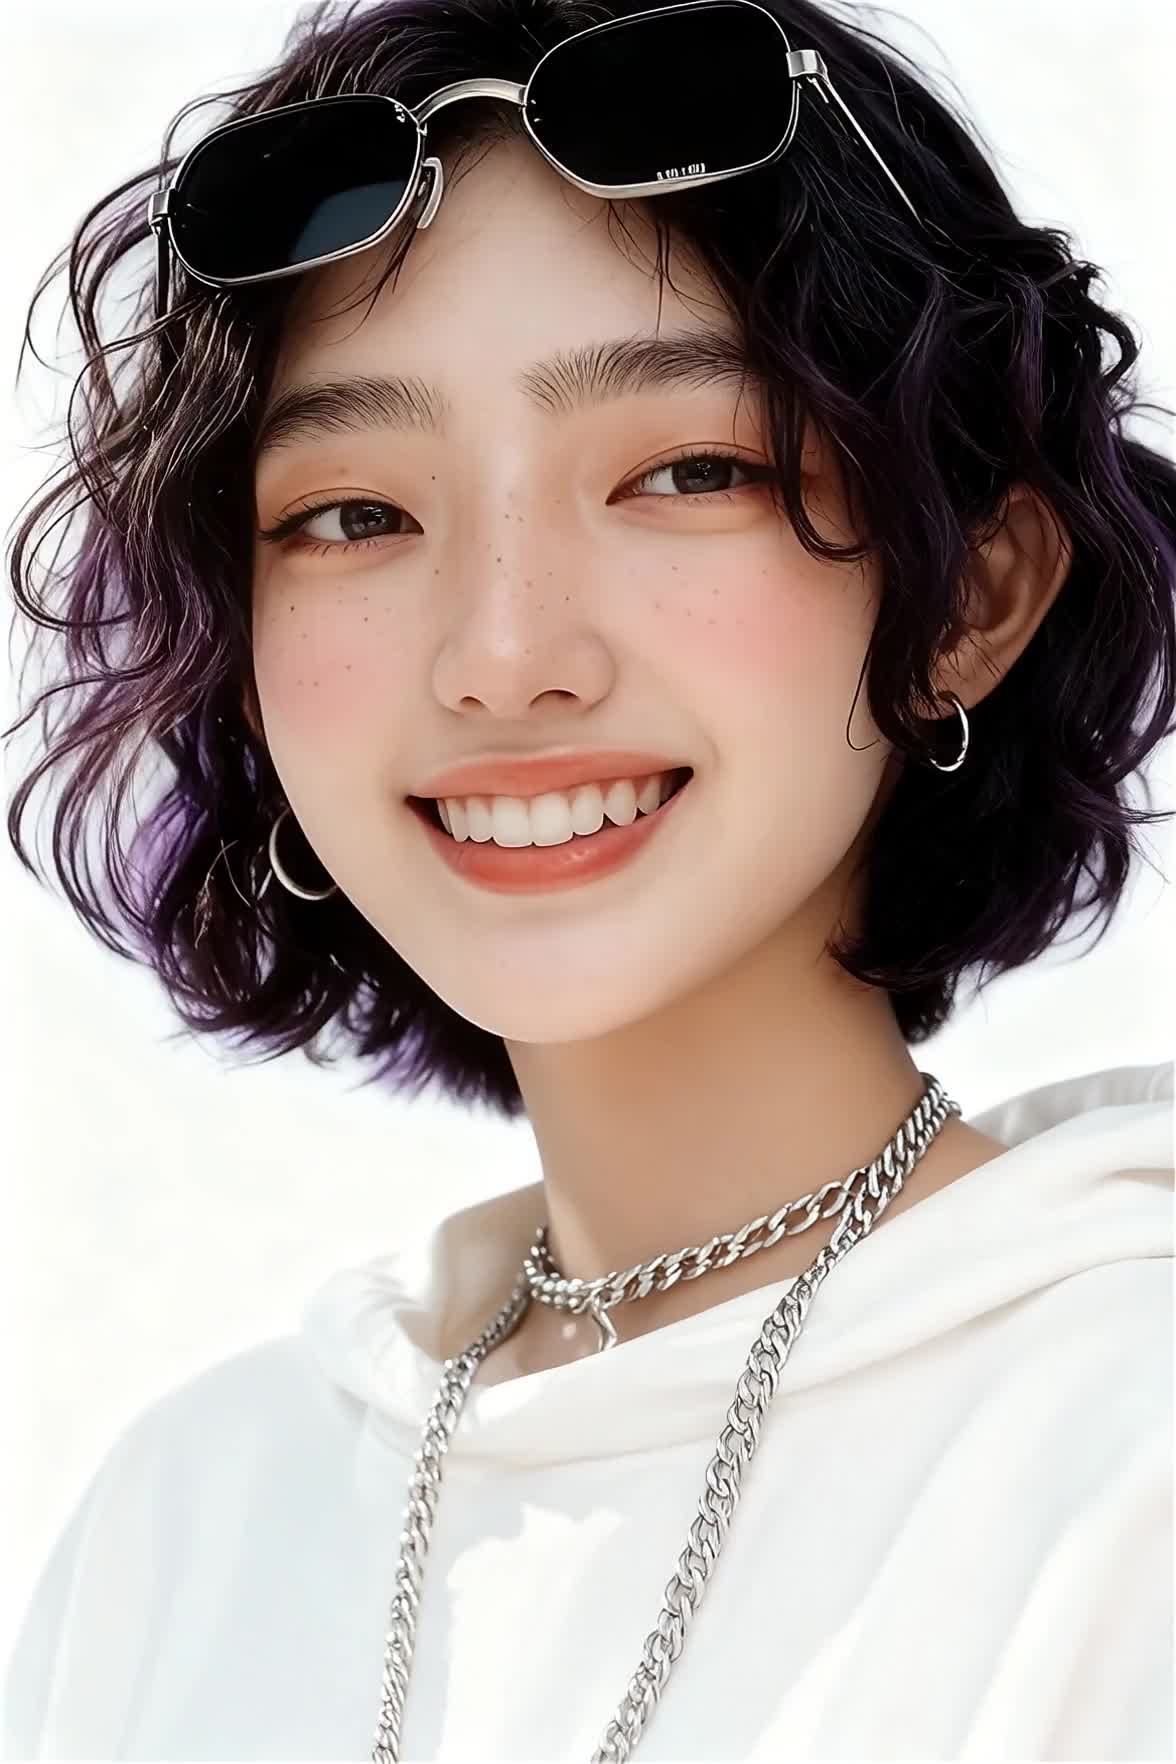
输入视频(视频1)参考人物
图1 的参考音色
视频1 的参考音色
输入图像(图2)参考物体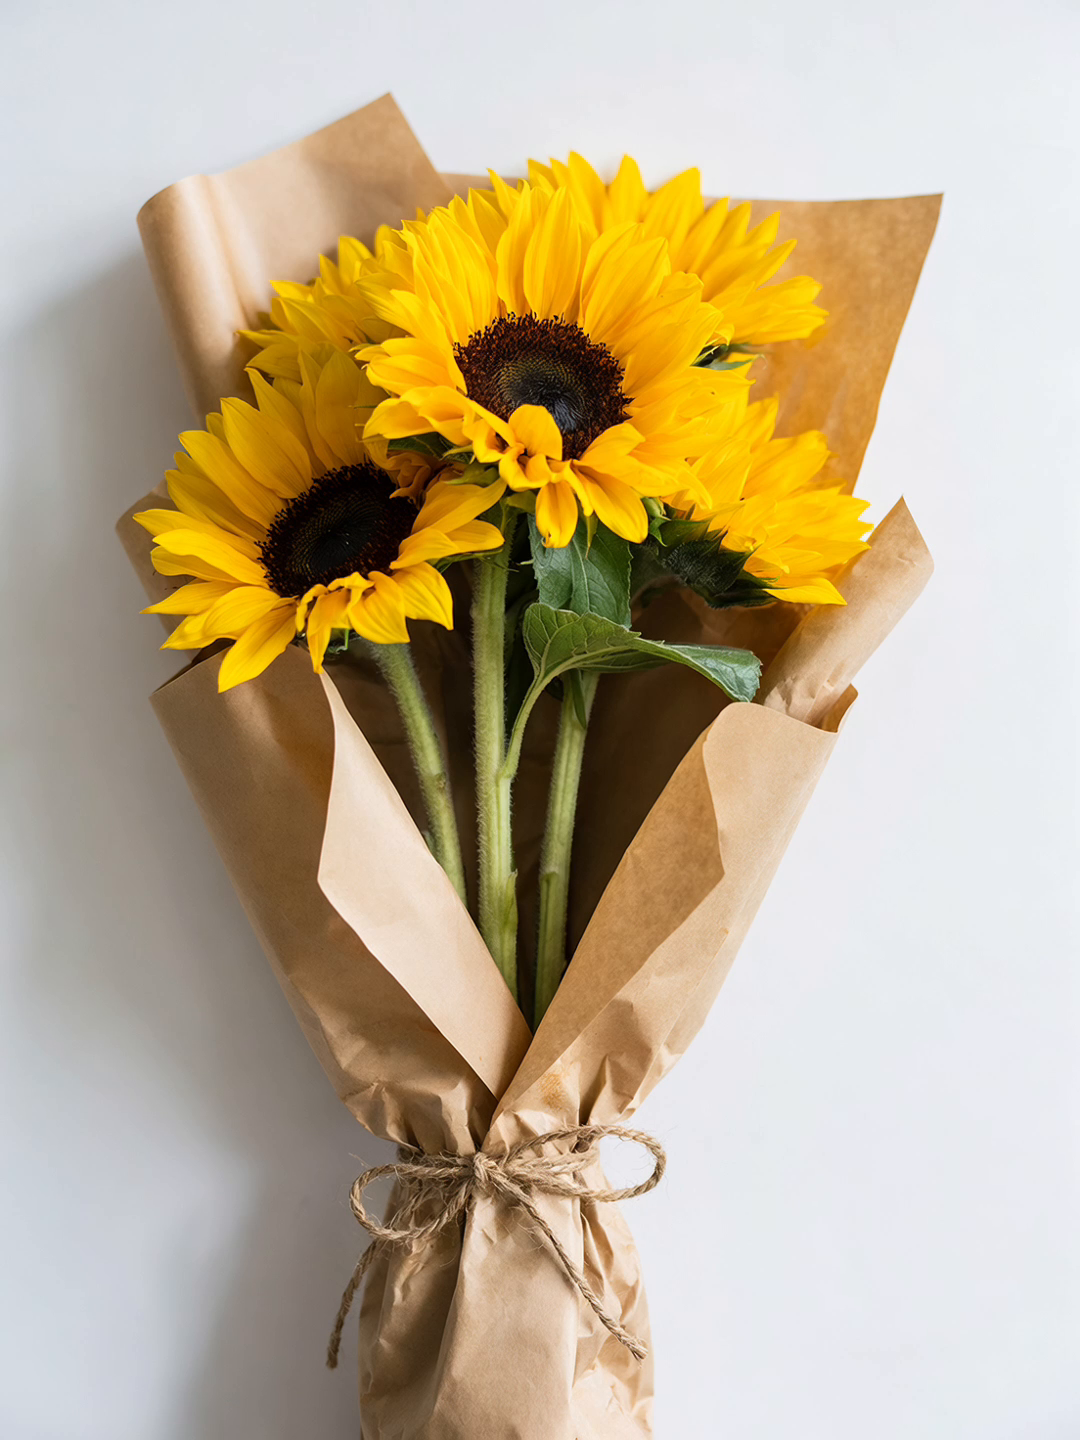
输入图像(图3)参考物体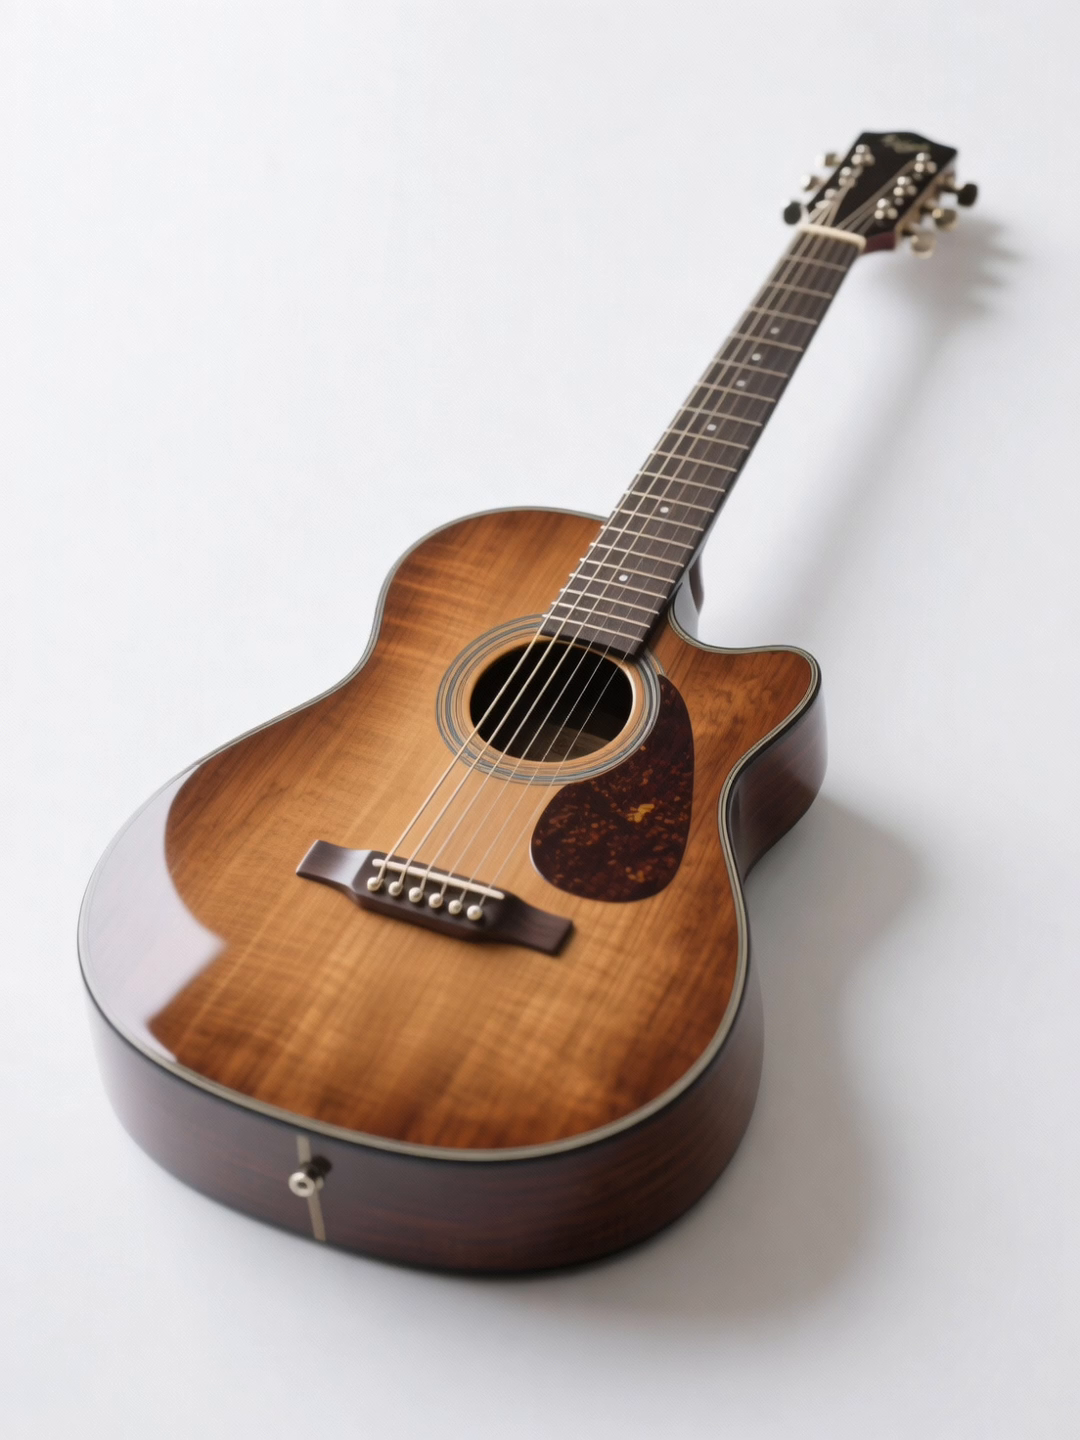
输入图像(图4)参考背景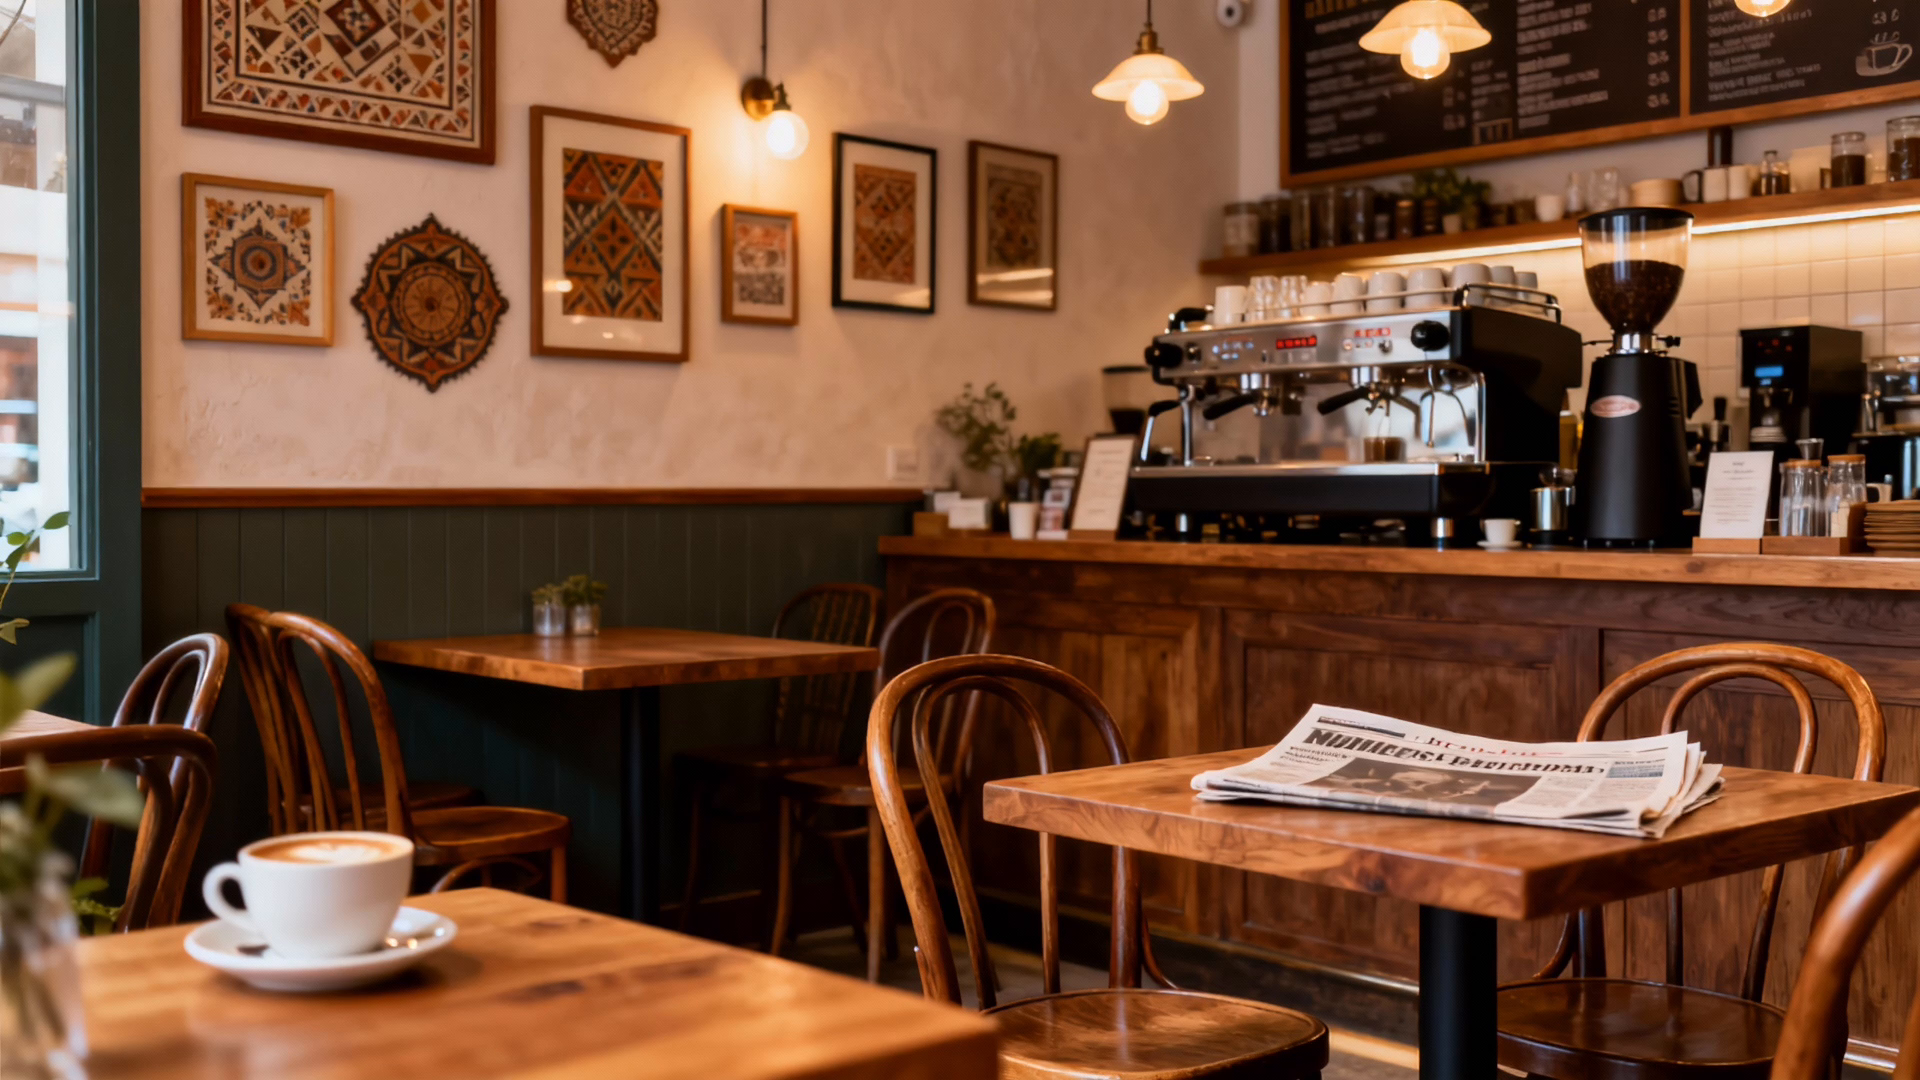
- Python SDK
- Java SDK
- curl
请确保 DashScope Python SDK 版本不低于
1.25.16,再运行以下代码。若版本过低,可能会触发 "url error, please check url!" 等错误。请参考安装SDK进行更新。核心能力(wan2.7模型)
单图参考(多宫格图)
支持模型:wan2.7系列模型。
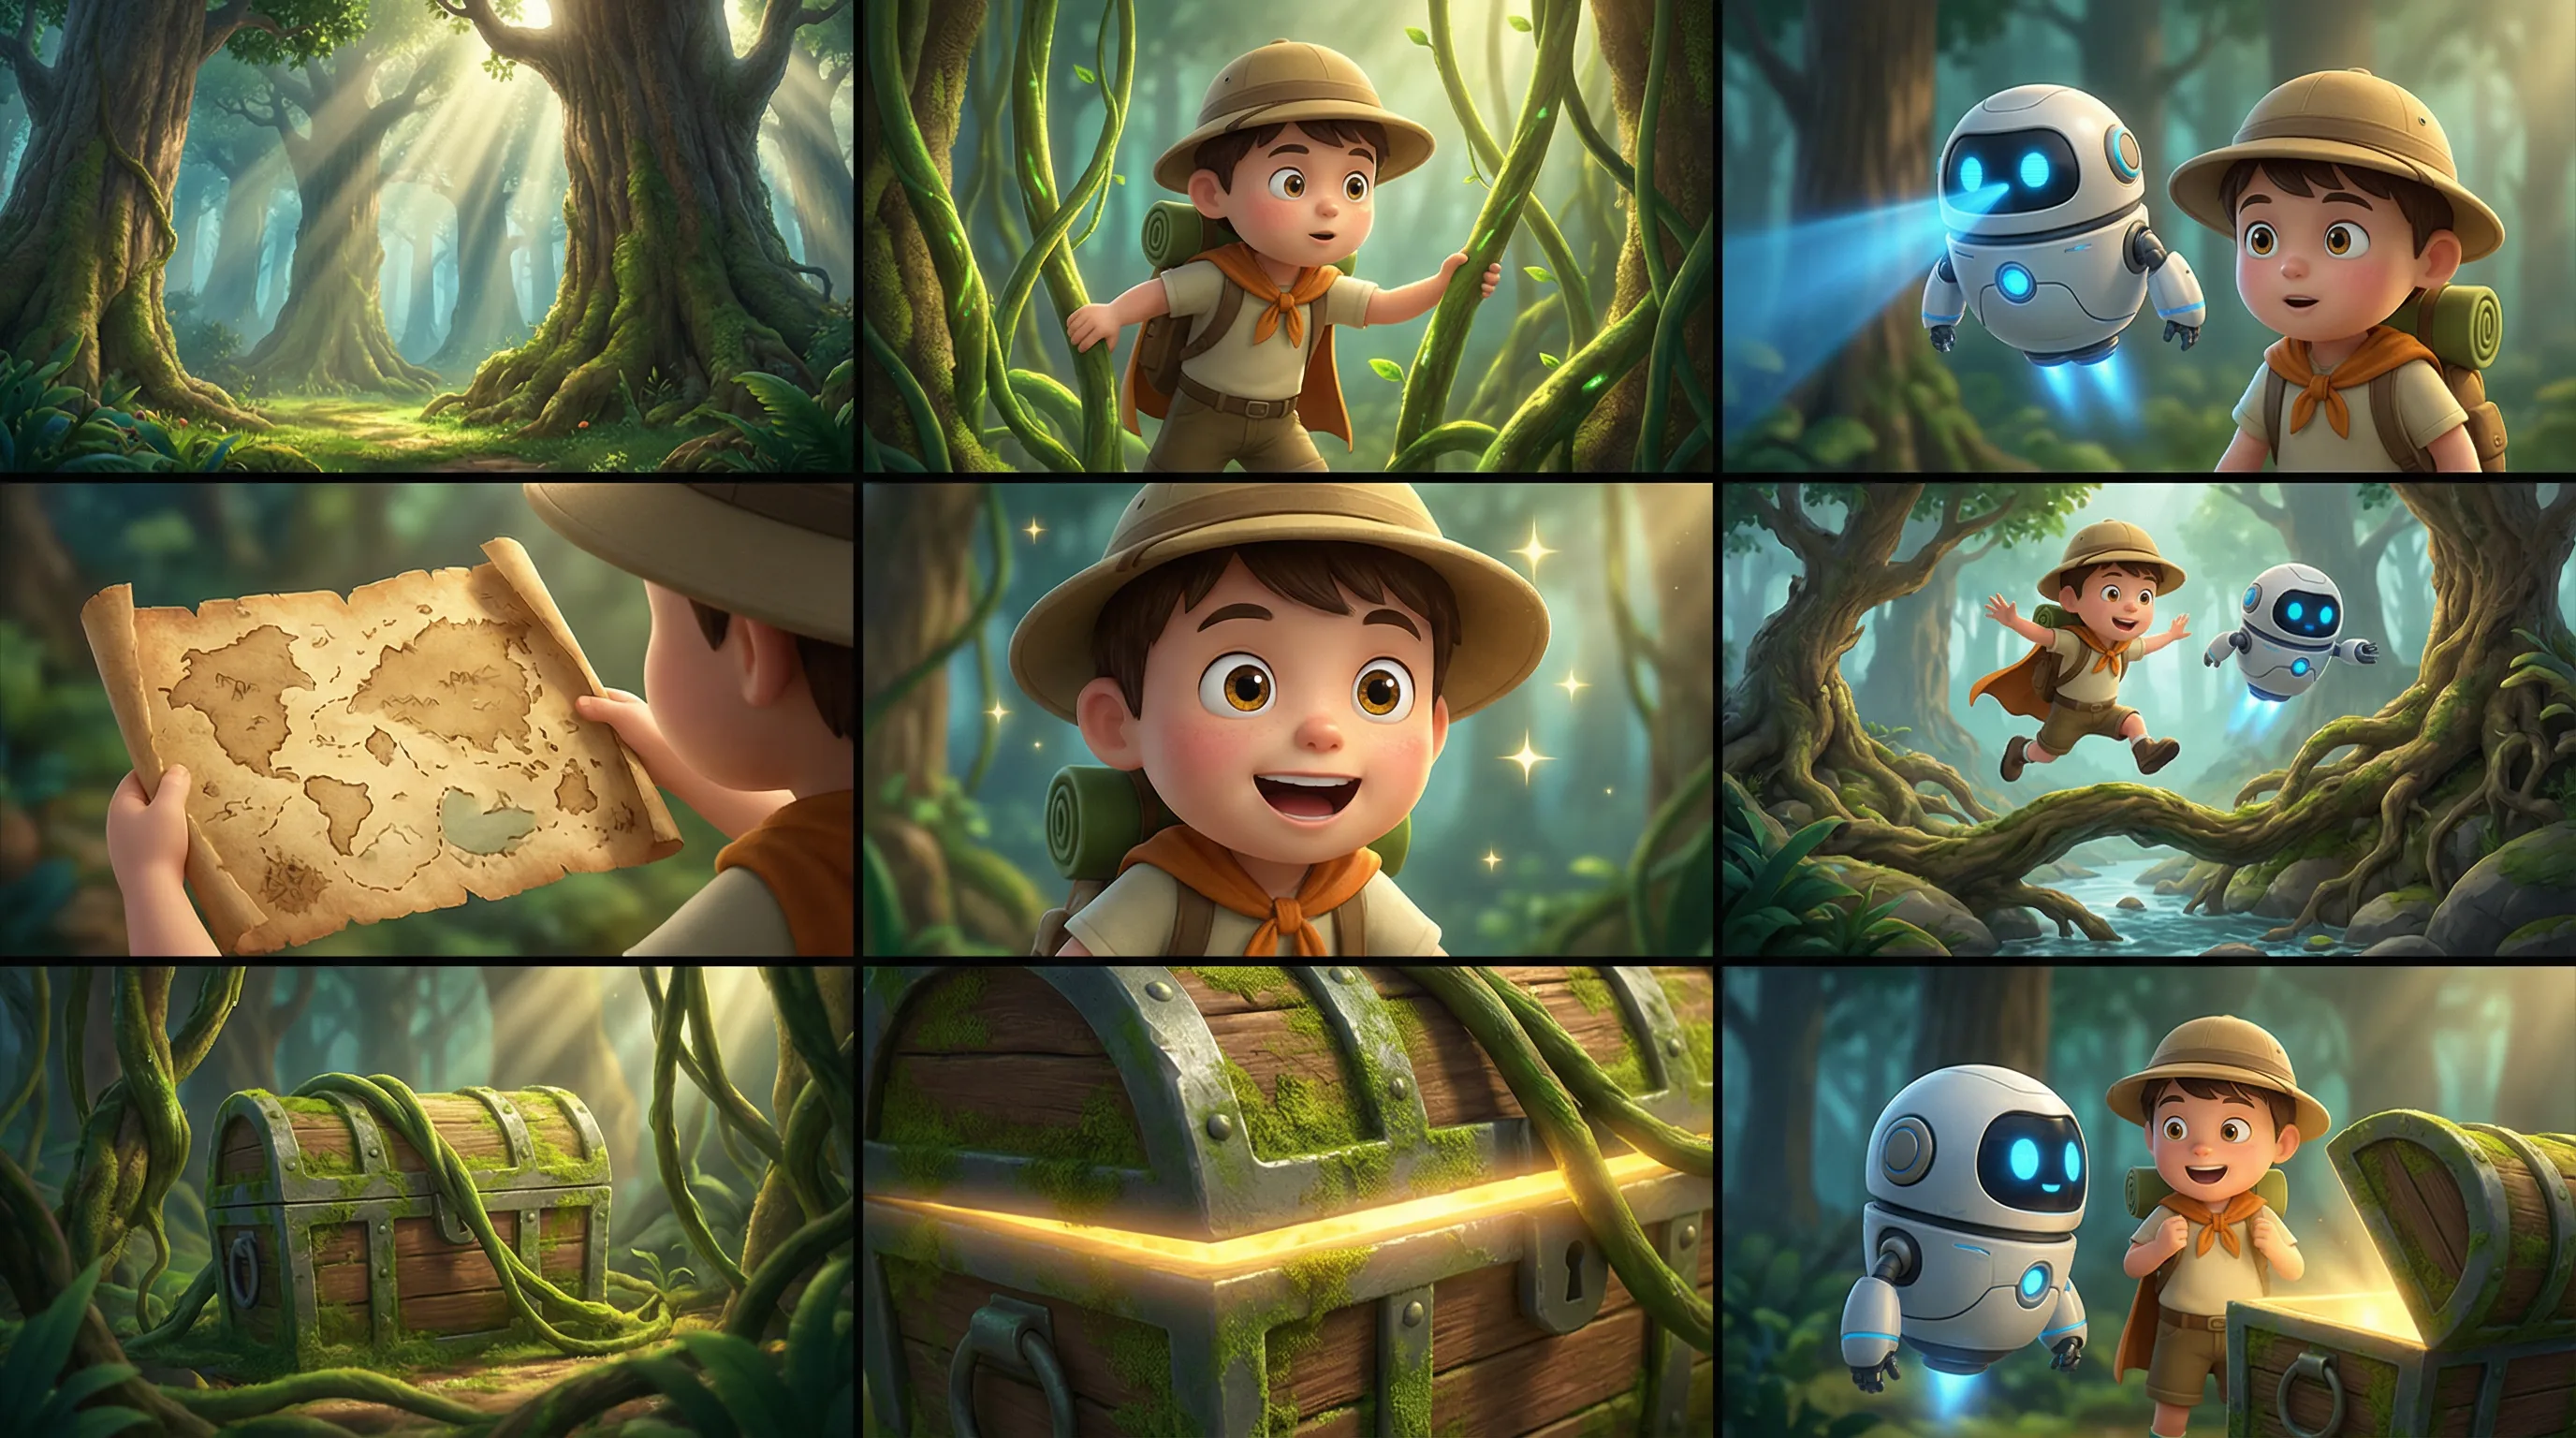
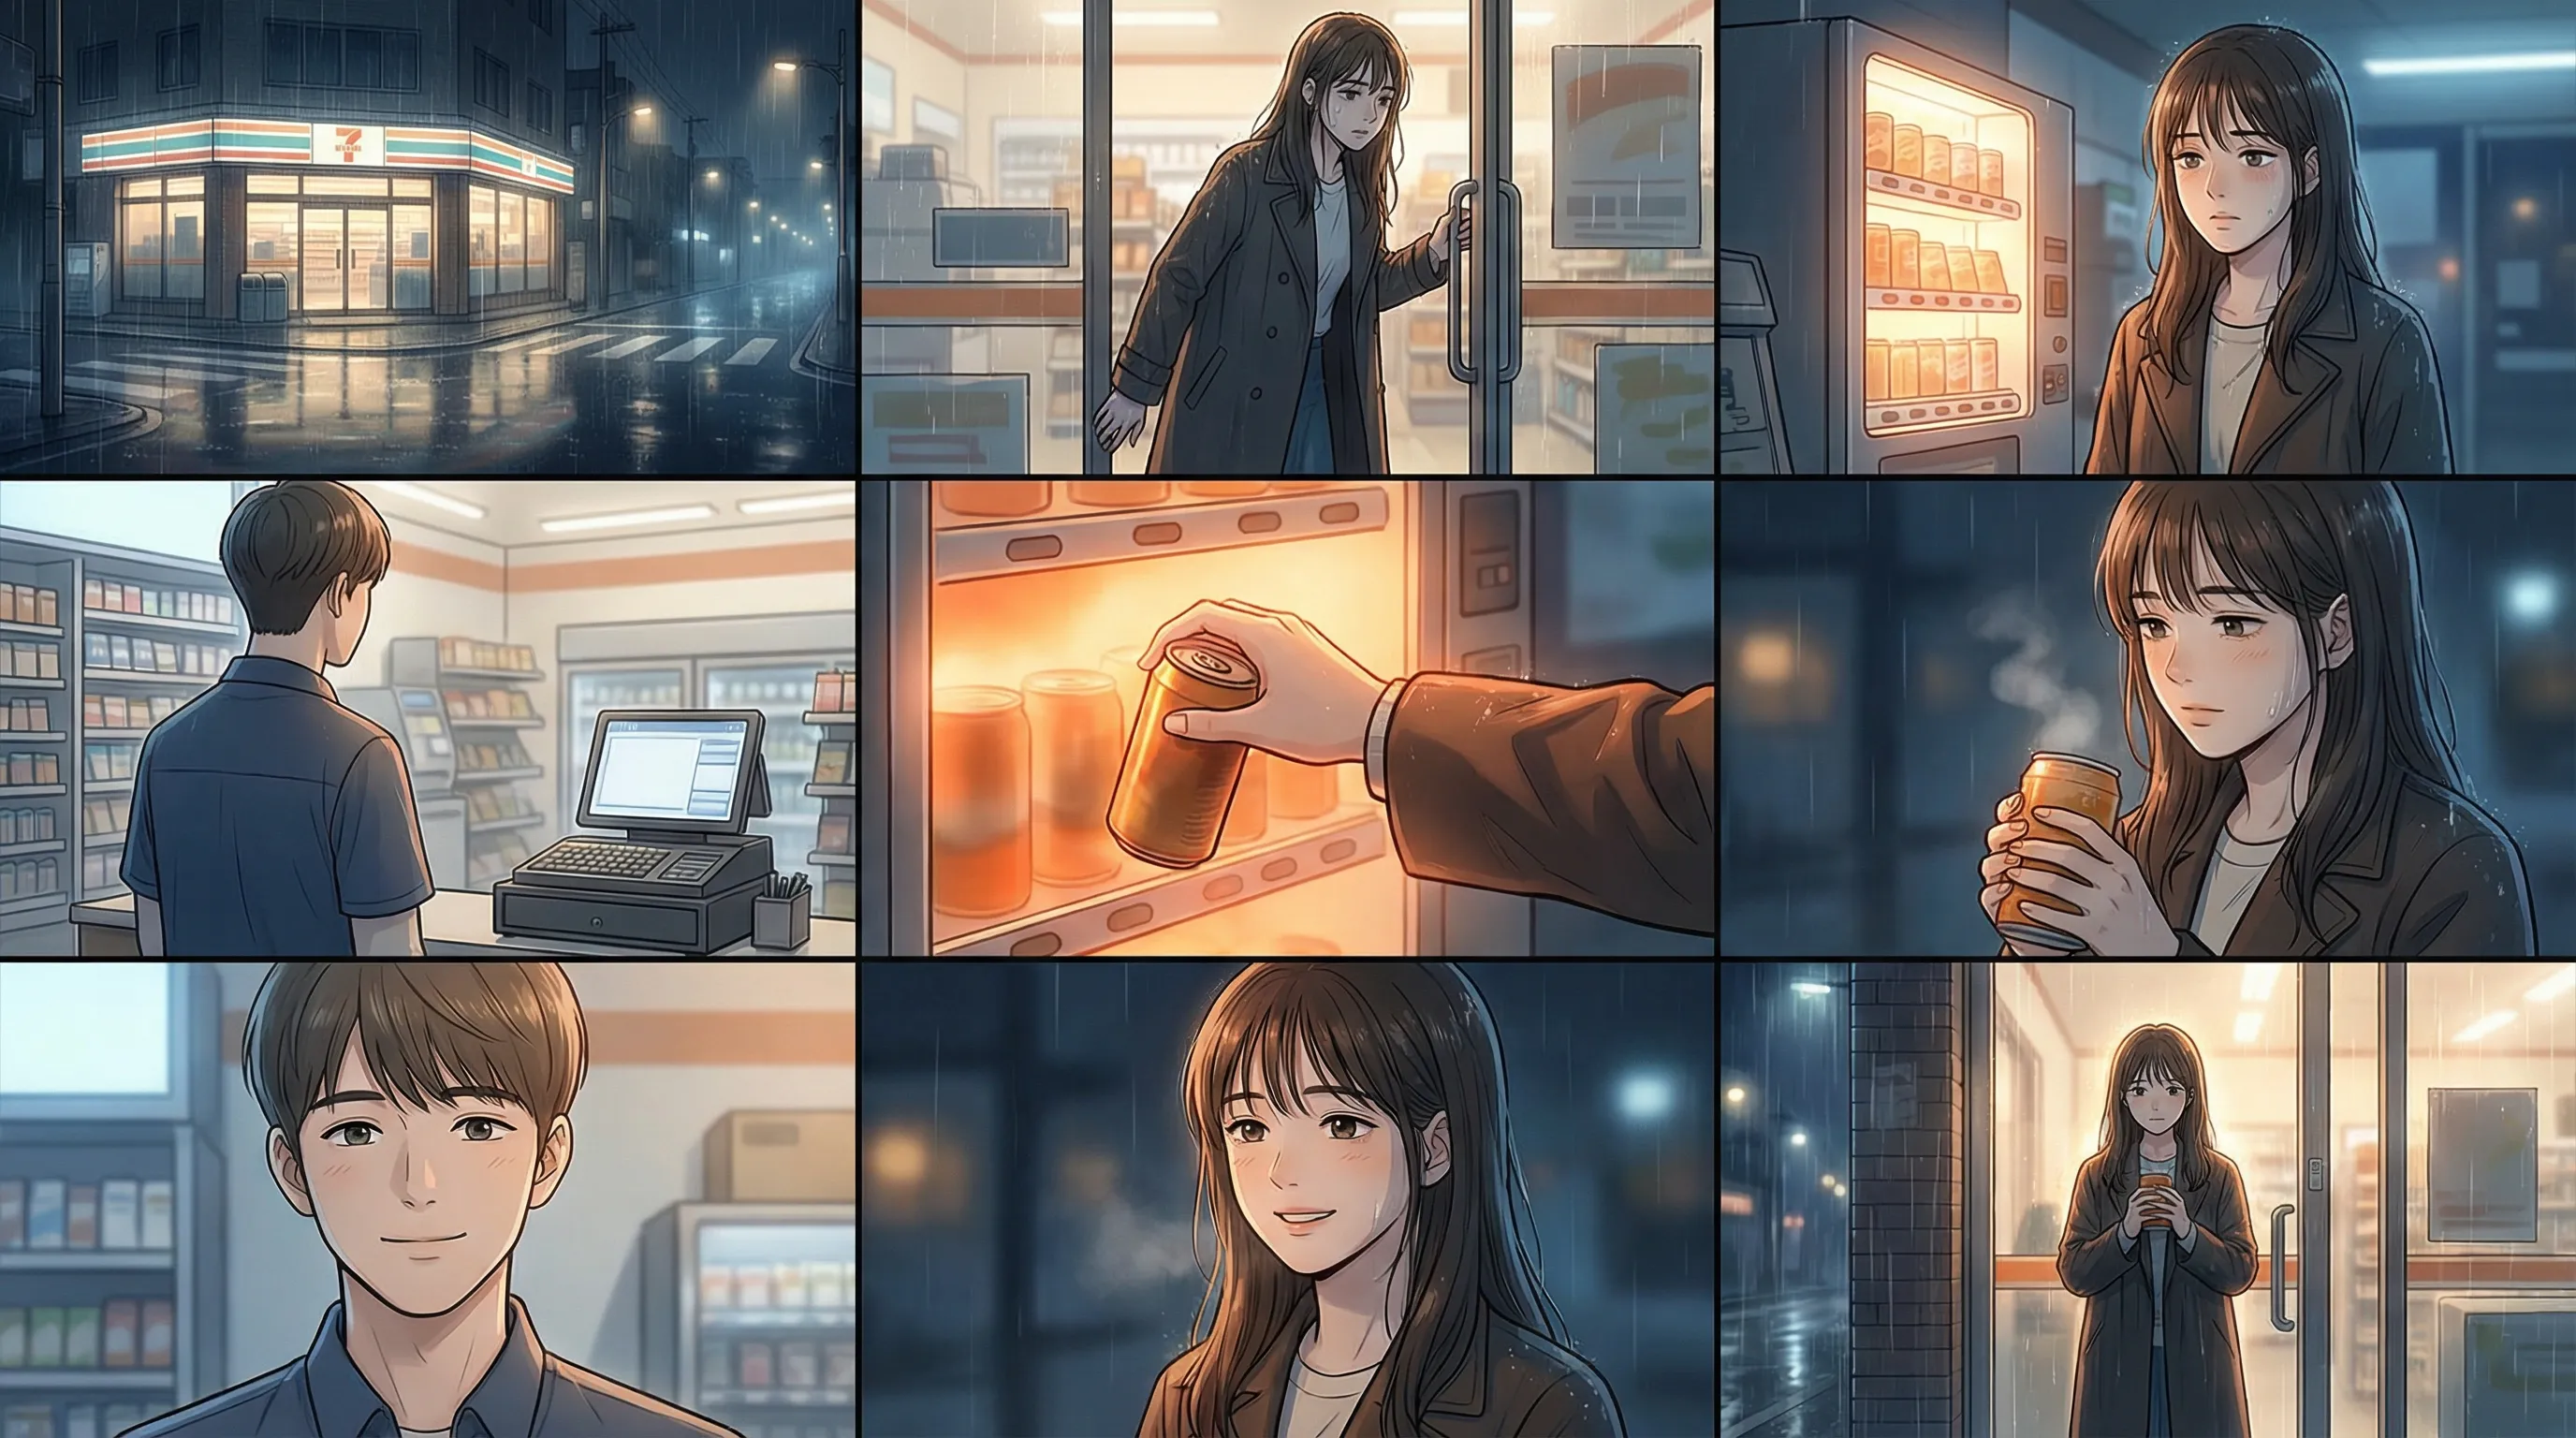
功能介绍:输入一张多宫格图(故事板),模型自动识别多宫格布局,生成角色、场景和镜头一致的视频。建议单次仅传入一张多宫格图。
参数设置:
media.type:设置为reference_image(参考图像)。media.url:多宫格图像的 URL 或 base64 编码字符串。prompt:当参考素材有且仅有一张图片或一个视频,则可表述为“参考图片”或“参考视频”。
| 输入提示词:参考图片 ,3D卡通冒险电影风,角色Q版但材质细腻,动作流畅,色彩鲜明,保持角色与森林场景一致,不要加入文字。氛围: 冒险、轻快、神秘、童趣。角色: 小男孩探险家:圆帽、背包、短斗篷。小伙伴:会飞的小机器人,圆形身体,蓝色发光眼。场景: 奇幻森林,巨大树根、蘑菇、藤蔓、藏宝洞口、阳光光束。分镜脚本: 1. 全景:奇幻森林里高大树木与光束交错,环境神秘明亮。 2. 中景:小男孩拨开藤蔓向前探路。 3. 中景:小机器人飞在他身边,用蓝光扫描前方。 4. 特写:一张旧藏宝图在男孩手里展开。 5. 近景:他露出兴奋表情,眼睛亮起来。 6. 动作镜头:两人跳过树根和小溪,继续深入森林。 7. 中景:藤蔓后方露出一个被苔藓覆盖的宝箱。 8. 特写:宝箱边缘闪出金色光芒。 9. 收束镜头:男孩和小机器人站在宝箱前惊喜对望,冒险感拉满。 | |
| 输入多宫格图像 | 输出视频 |
 | |
| 输入提示词:参考图片,韩漫风格,夜晚灯光柔和,人物表情细腻,场景统一,图中不要出现文字。氛围: 治愈、安静、微孤独、温柔。角色: 女主:打工结束的年轻女生,长外套,疲惫但温柔。店员少年:便利店夜班店员,清爽短发。场景: 深夜便利店,暖白灯,货架整齐,玻璃门外有细雨和街灯。分镜脚本: 1. 全景:深夜便利店在雨夜街角亮着暖白色灯光。 2. 中景:女主推门走进店里,肩上还带着夜雨湿气。 3. 近景:她疲惫地站在热饮柜前,轻轻发呆。 4. 中景:店员少年从收银台抬头看见她。 5. 特写:热饮柜的橙色灯光映在她手边。 6. 近景:女主拿起一罐热饮,神情稍微放松。 7. 近景:店员朝她露出温和而克制的笑并说:”今天也辛苦啦。” 8. 中景:女主回以浅浅笑意,疲惫感被冲淡。 9. 收束镜头:她捧着热饮站在店门前,看着雨夜,便利店灯光把背影映得很温柔。 | |
| 输入多宫格图像 | 输出视频 |
 | |
- Python SDK
- Java SDK
- curl
请确保 DashScope Python SDK 版本不低于 1.25.16,可参考安装SDK进行更新。
多主体参考+音色定制
支持模型:wan2.7系列模型。
功能介绍:支持传入多个参考图像和参考视频作为主体素材,并可为每个主体独立指定音色,实现多角色同框互动与音色区分。
参数设置:
-
media:参考素材数组。-
media.type:支持reference_image(参考图像)和reference_video(参考视频)。参考图像 + 参考视频 ≤ 5。 -
media.url:素材的 URL;图像还支持 base64 编码字符串。 -
media.reference_voice(可选):为主体指定音色的音频 URL,推荐与reference_image或reference_video搭配使用。 音频生效逻辑:若reference_video本身包含音频且未指定reference_voice,默认使用视频原声;若同时传入,reference_voice将覆盖视频原声。
-
-
prompt:在提示词中指代参考素材,规则如下:- 使用“图1、图2”指代
reference_image素材,使用“视频1、视频2”指代reference_video素材,英文提示词则写为“Image 1”、"Video 1”这类标识。 - 按照
media数组定义参考素材的引用顺序,图和视频分别计数。
- 使用“图1、图2”指代
输入图像(图1)参考人物
输入视频(视频1)参考人物
图1 的参考音色
视频1 的参考音色
输入图像(图2)参考物体
输入图像(图3)参考物体
输入图像(图4)参考背景
输入提示词:图2从画面左侧深处走来,随后切换到图2的特写,图1正靠在右侧图片3充满锈迹的墙壁上发呆。她注意到了脚步声,缓缓转头。 图1看到图2后,图1说:“你怎么还是来了?”图2回答:“我们谈谈吧。”
输入图像(图1)参考人物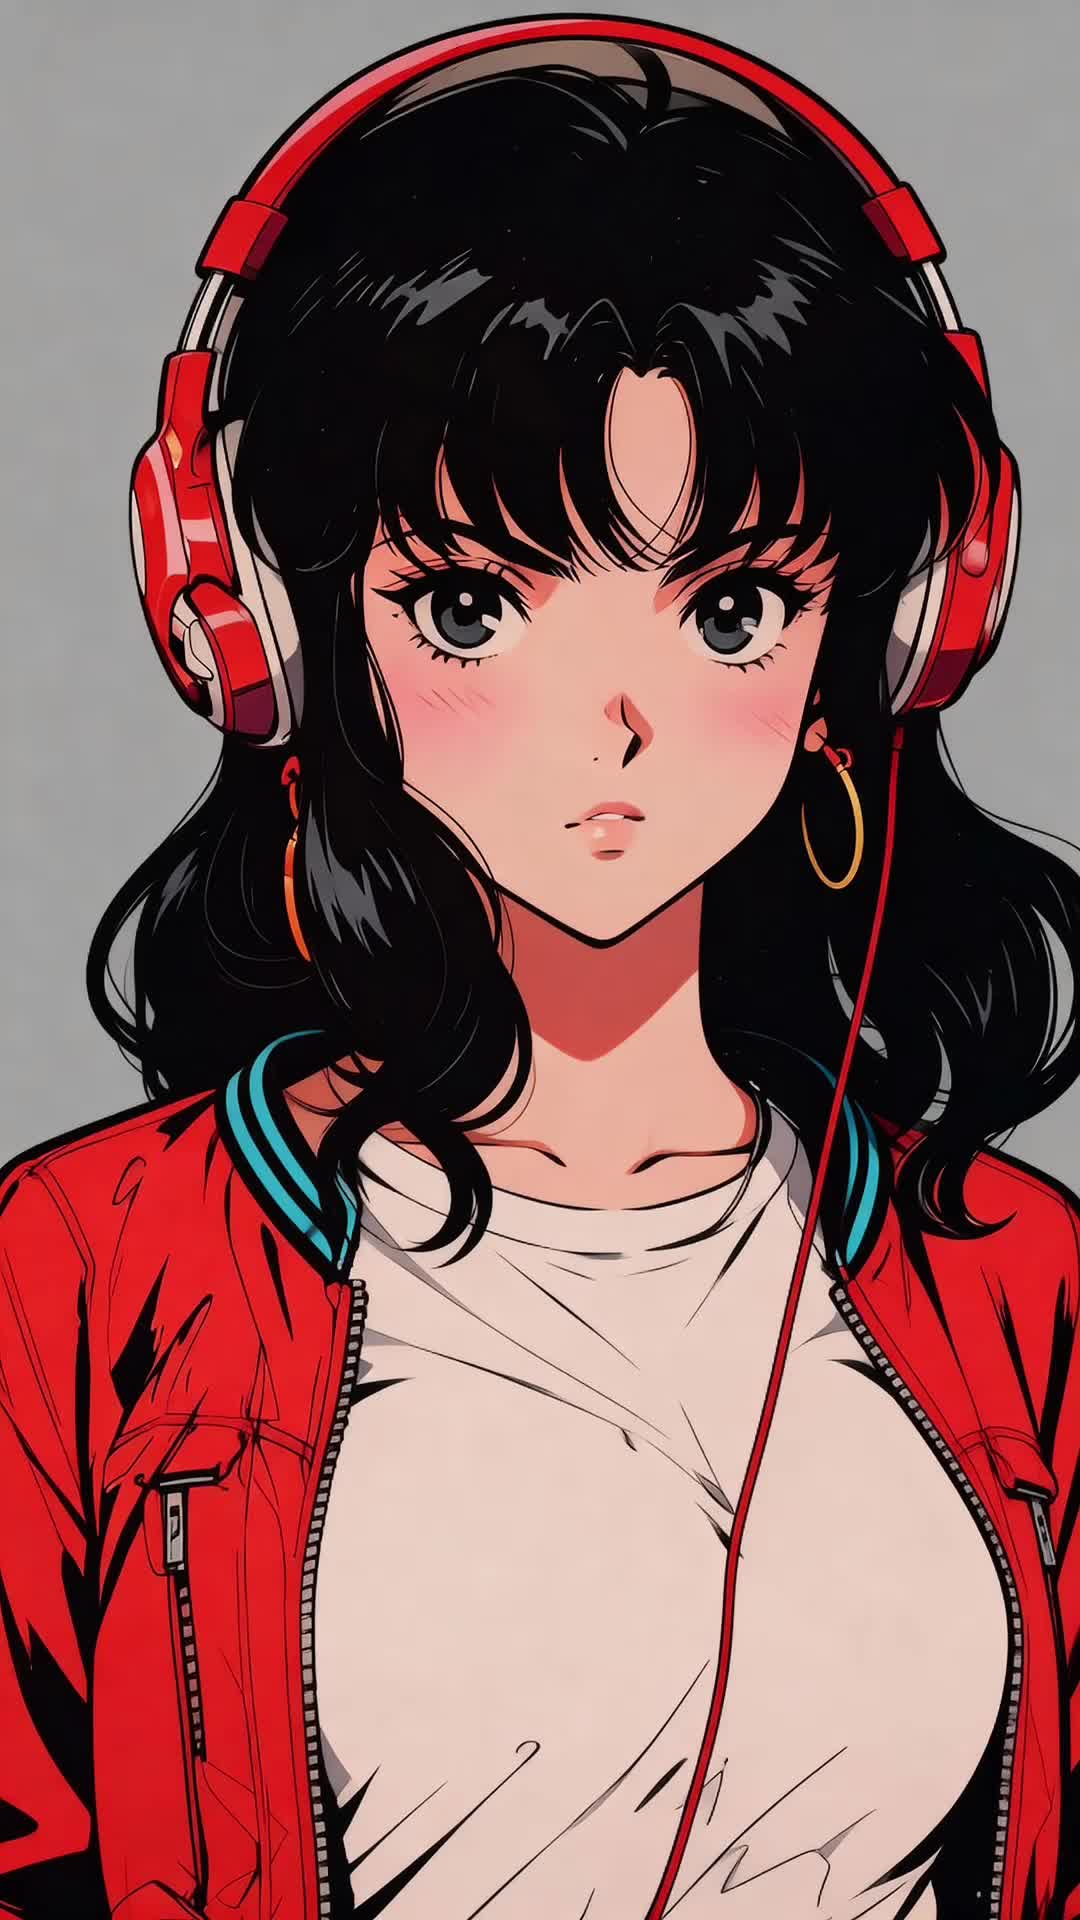
输入图像(图2)参考人物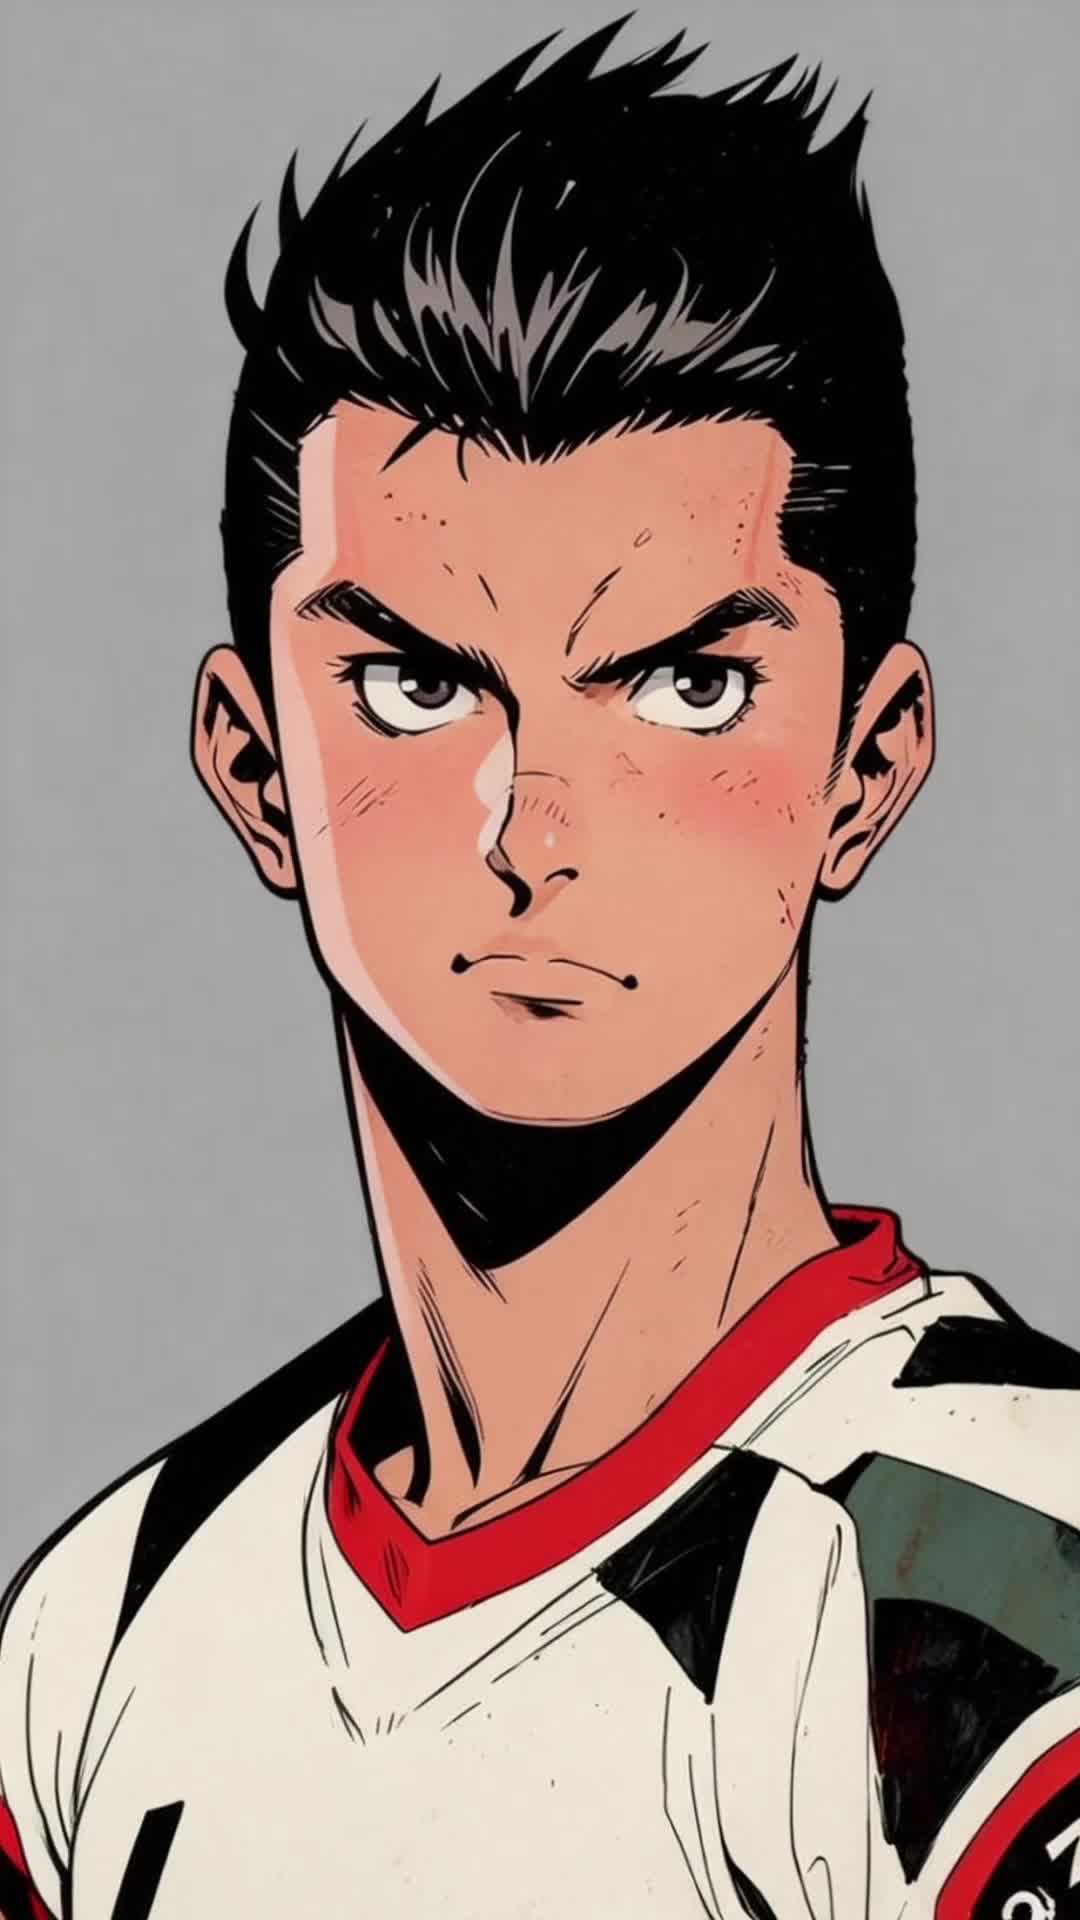
输入图像(图3)参考背景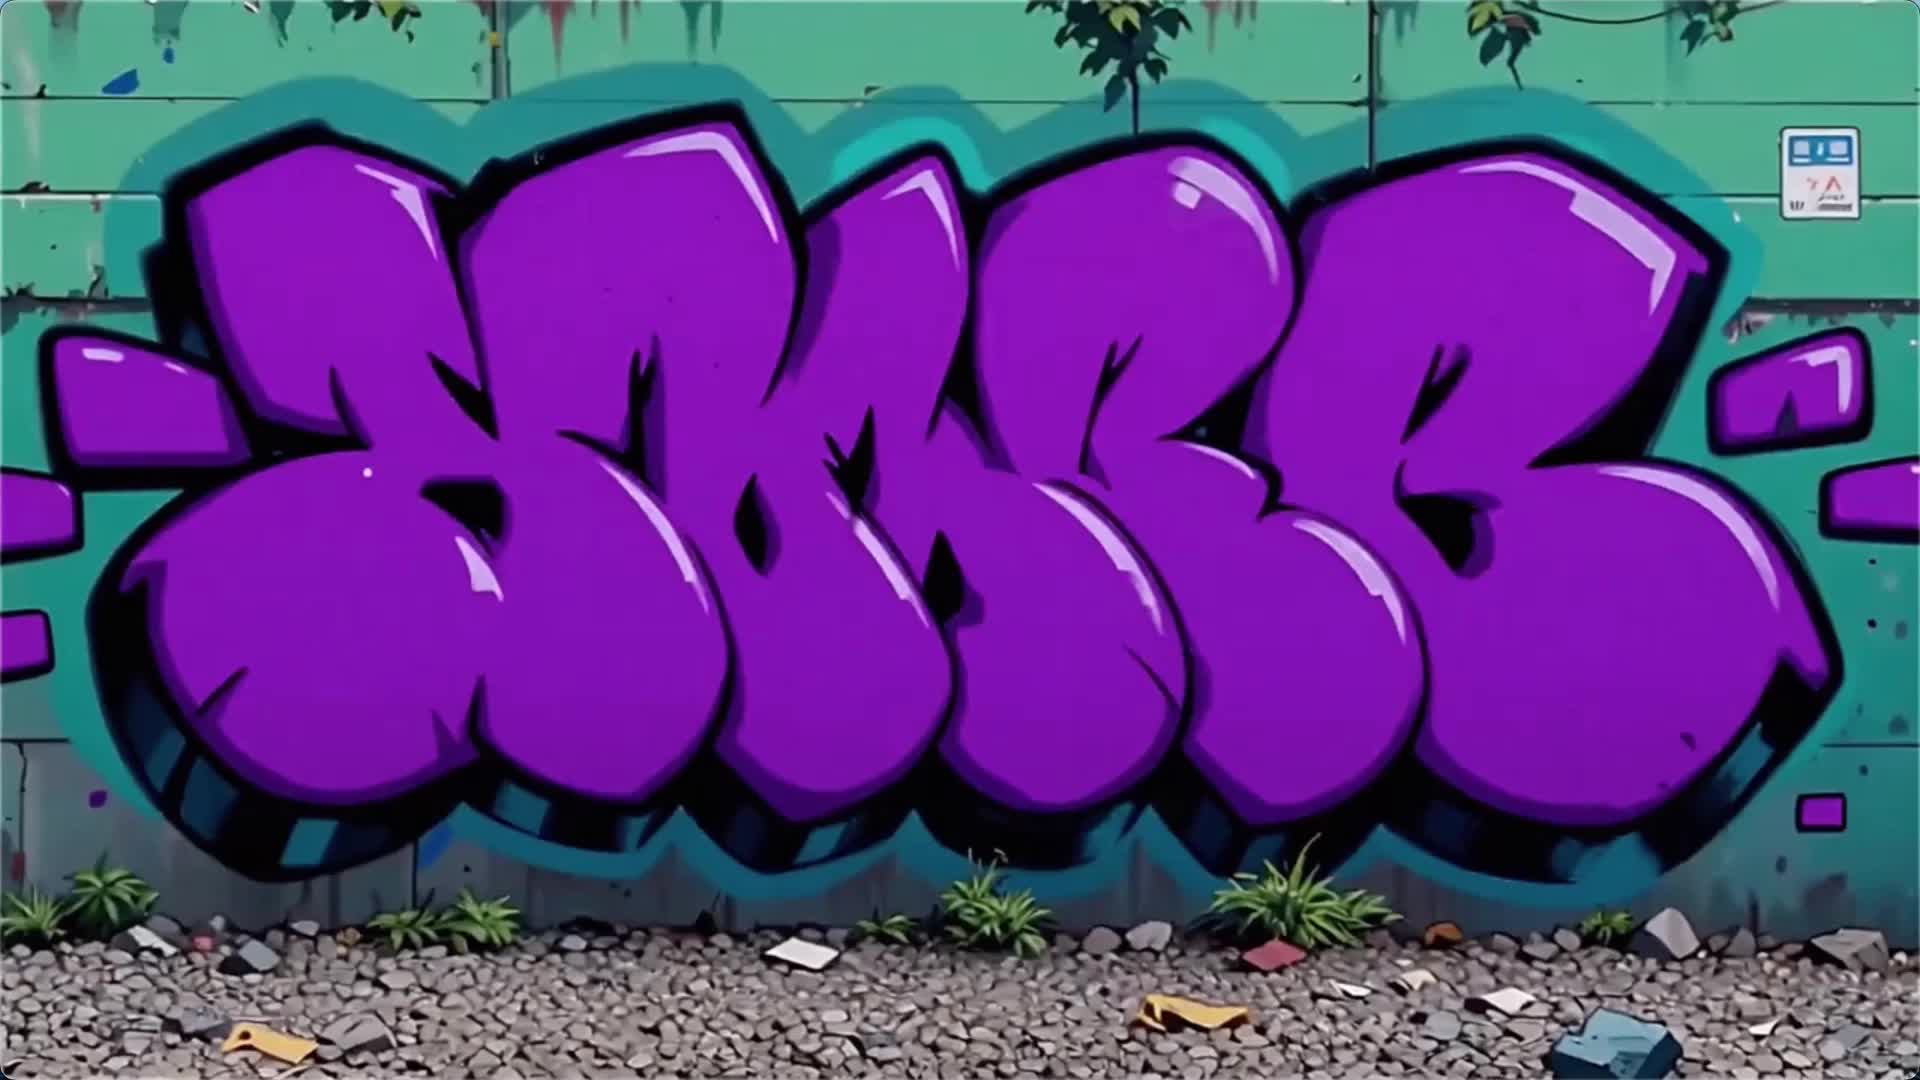
图1 的参考音色
图2 的参考音色
- Python SDK
- Java SDK
- curl
请确保 DashScope Python SDK 版本不低于 1.25.16,可参考安装SDK进行更新。
多主体参考+首帧控制
支持模型:wan2.7系列模型。
功能介绍:在主体参考基础上加入首帧控制,让画面构图和内容走向更加可控。
参数设置:
-
media:参考素材数组。-
media.type:支持first_frame、reference_image(参考图像)和reference_video(参考视频)。 首帧图像最多1张,参考图像和参考视频至少传入1个,参考图像 + 参考视频 ≤ 5。 -
media.url:素材的 URL;图像还支持 base64 编码字符串。
-
-
prompt:在提示词中指代参考素材,规则如下:- 使用“图1、图2”指代
reference_image素材,使用“视频1、视频2”指代reference_video素材,英文提示词则写为“Image 1”、"Video 1”这类标识。 - 按照
media数组定义参考素材的引用顺序,图和视频分别计数。 - 首帧无需在提示词中引用。
- 使用“图1、图2”指代
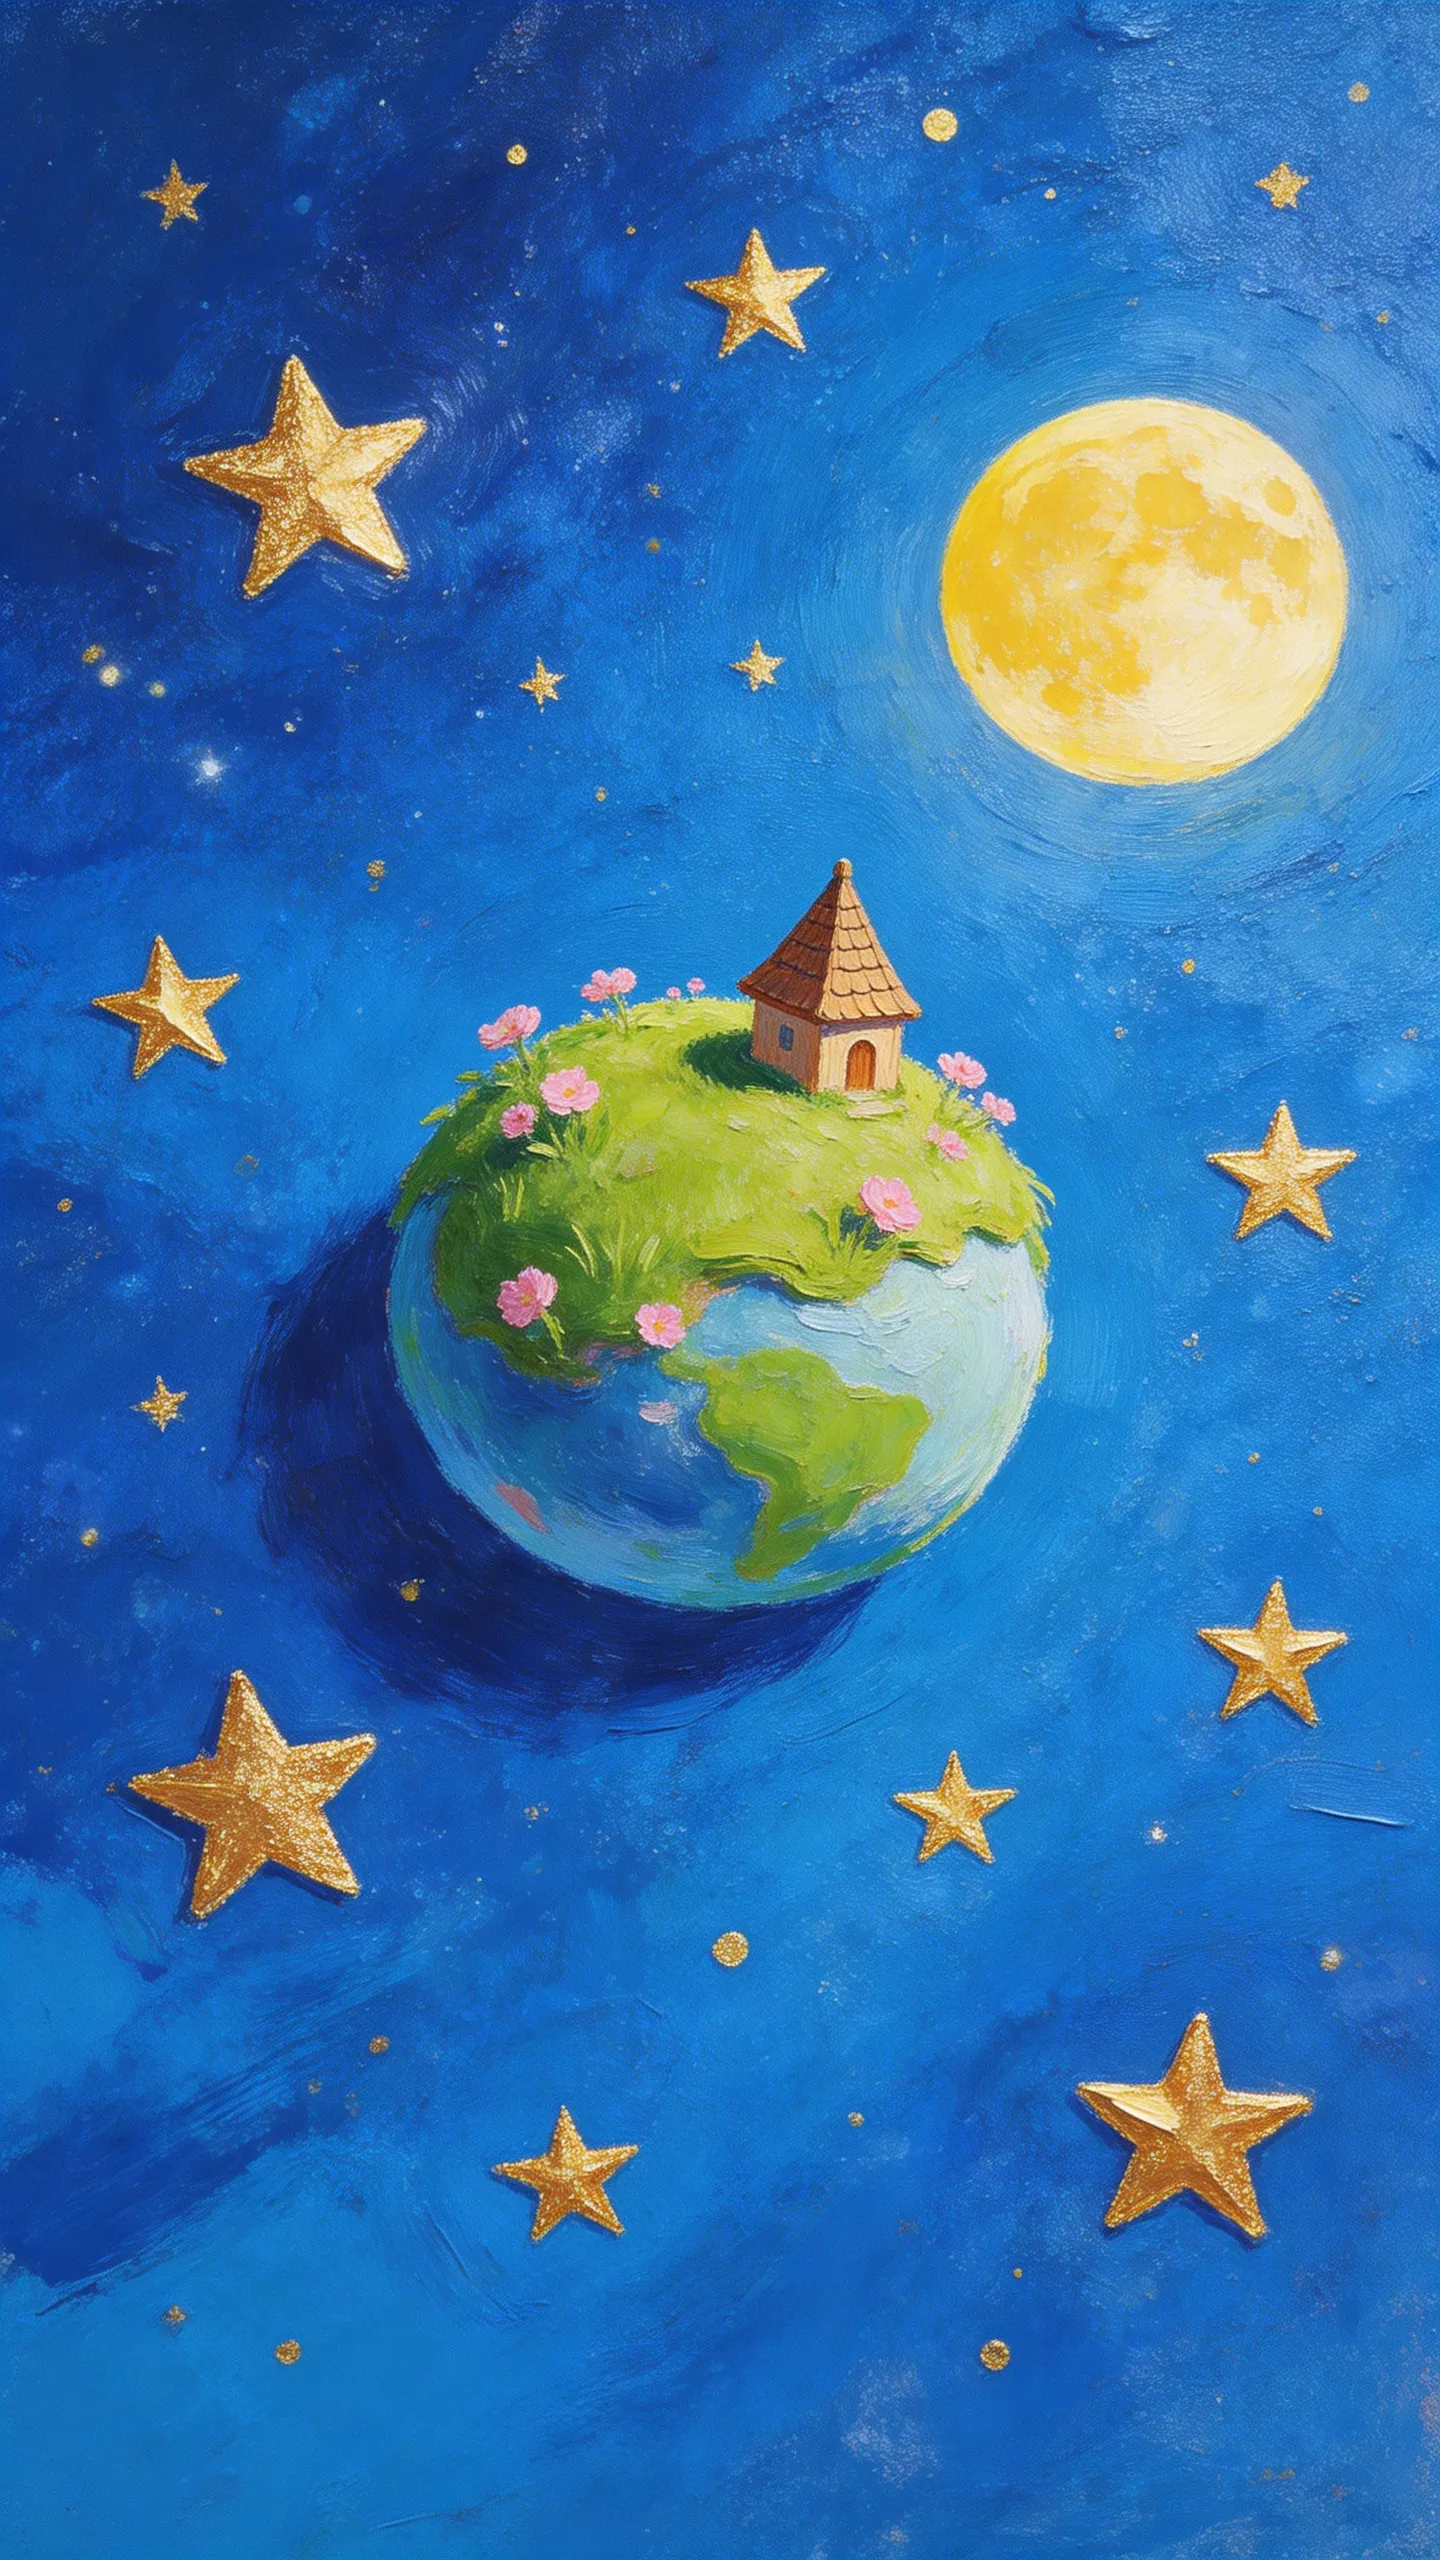
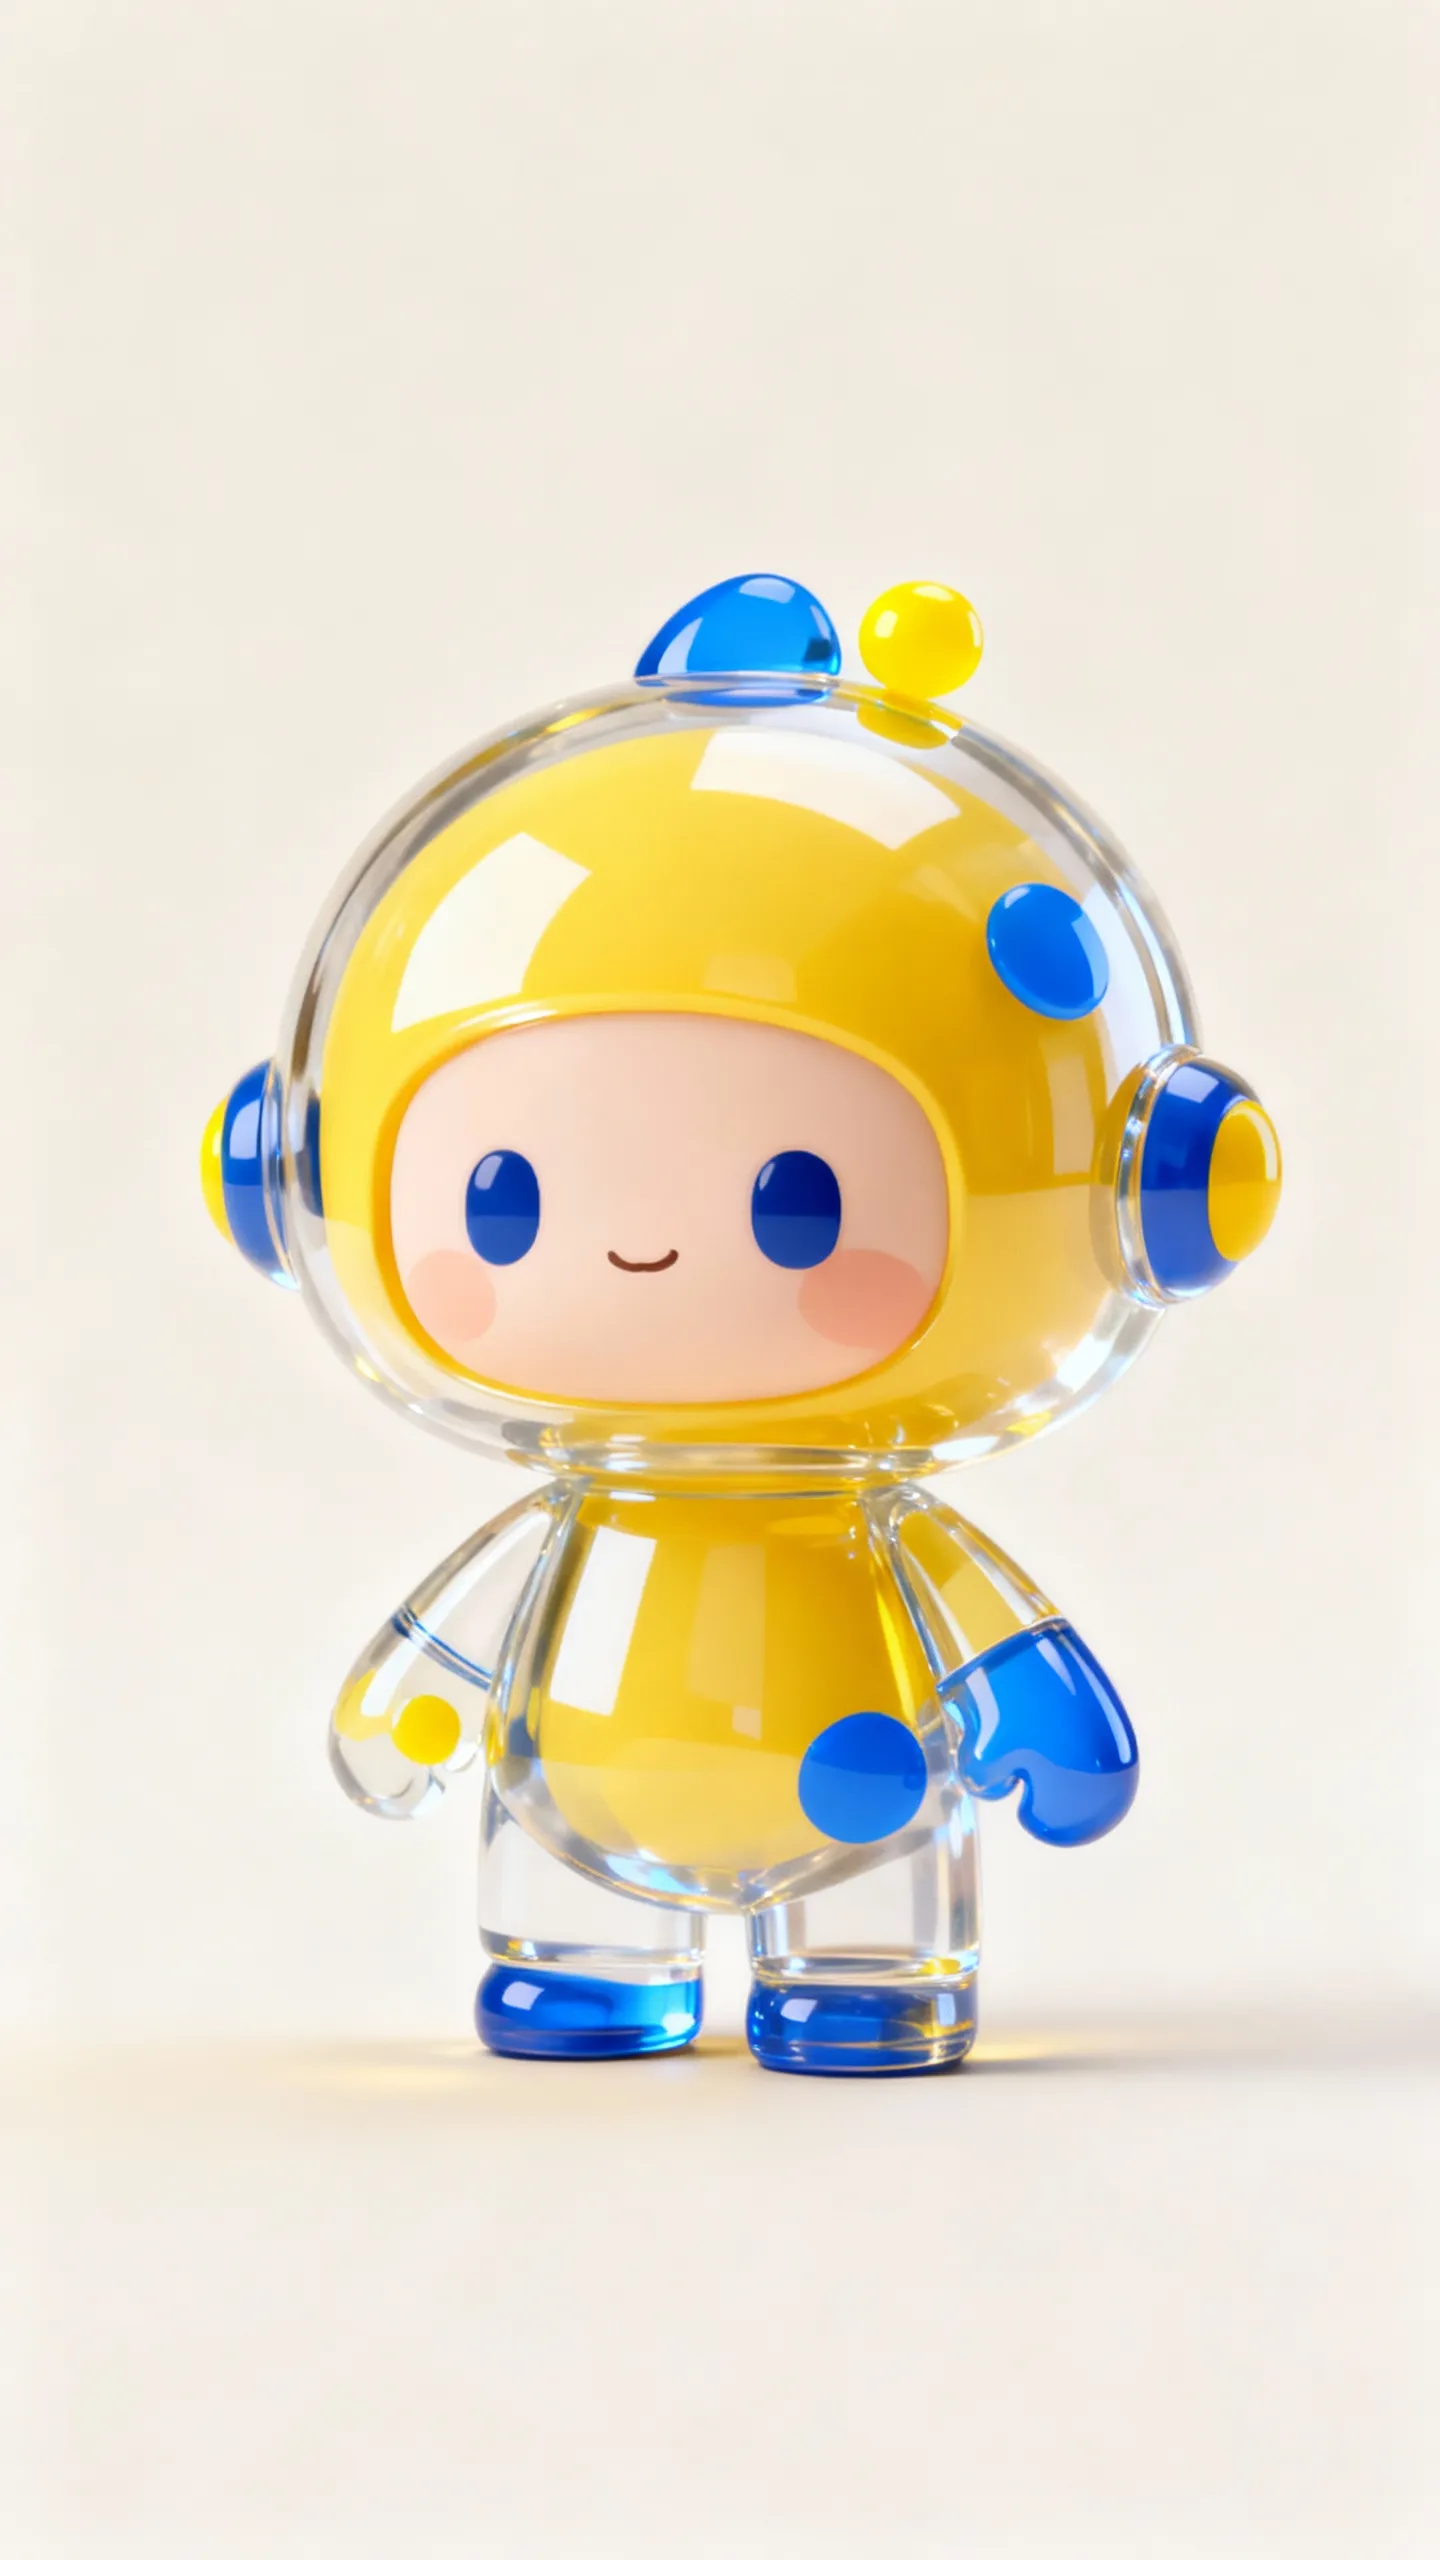
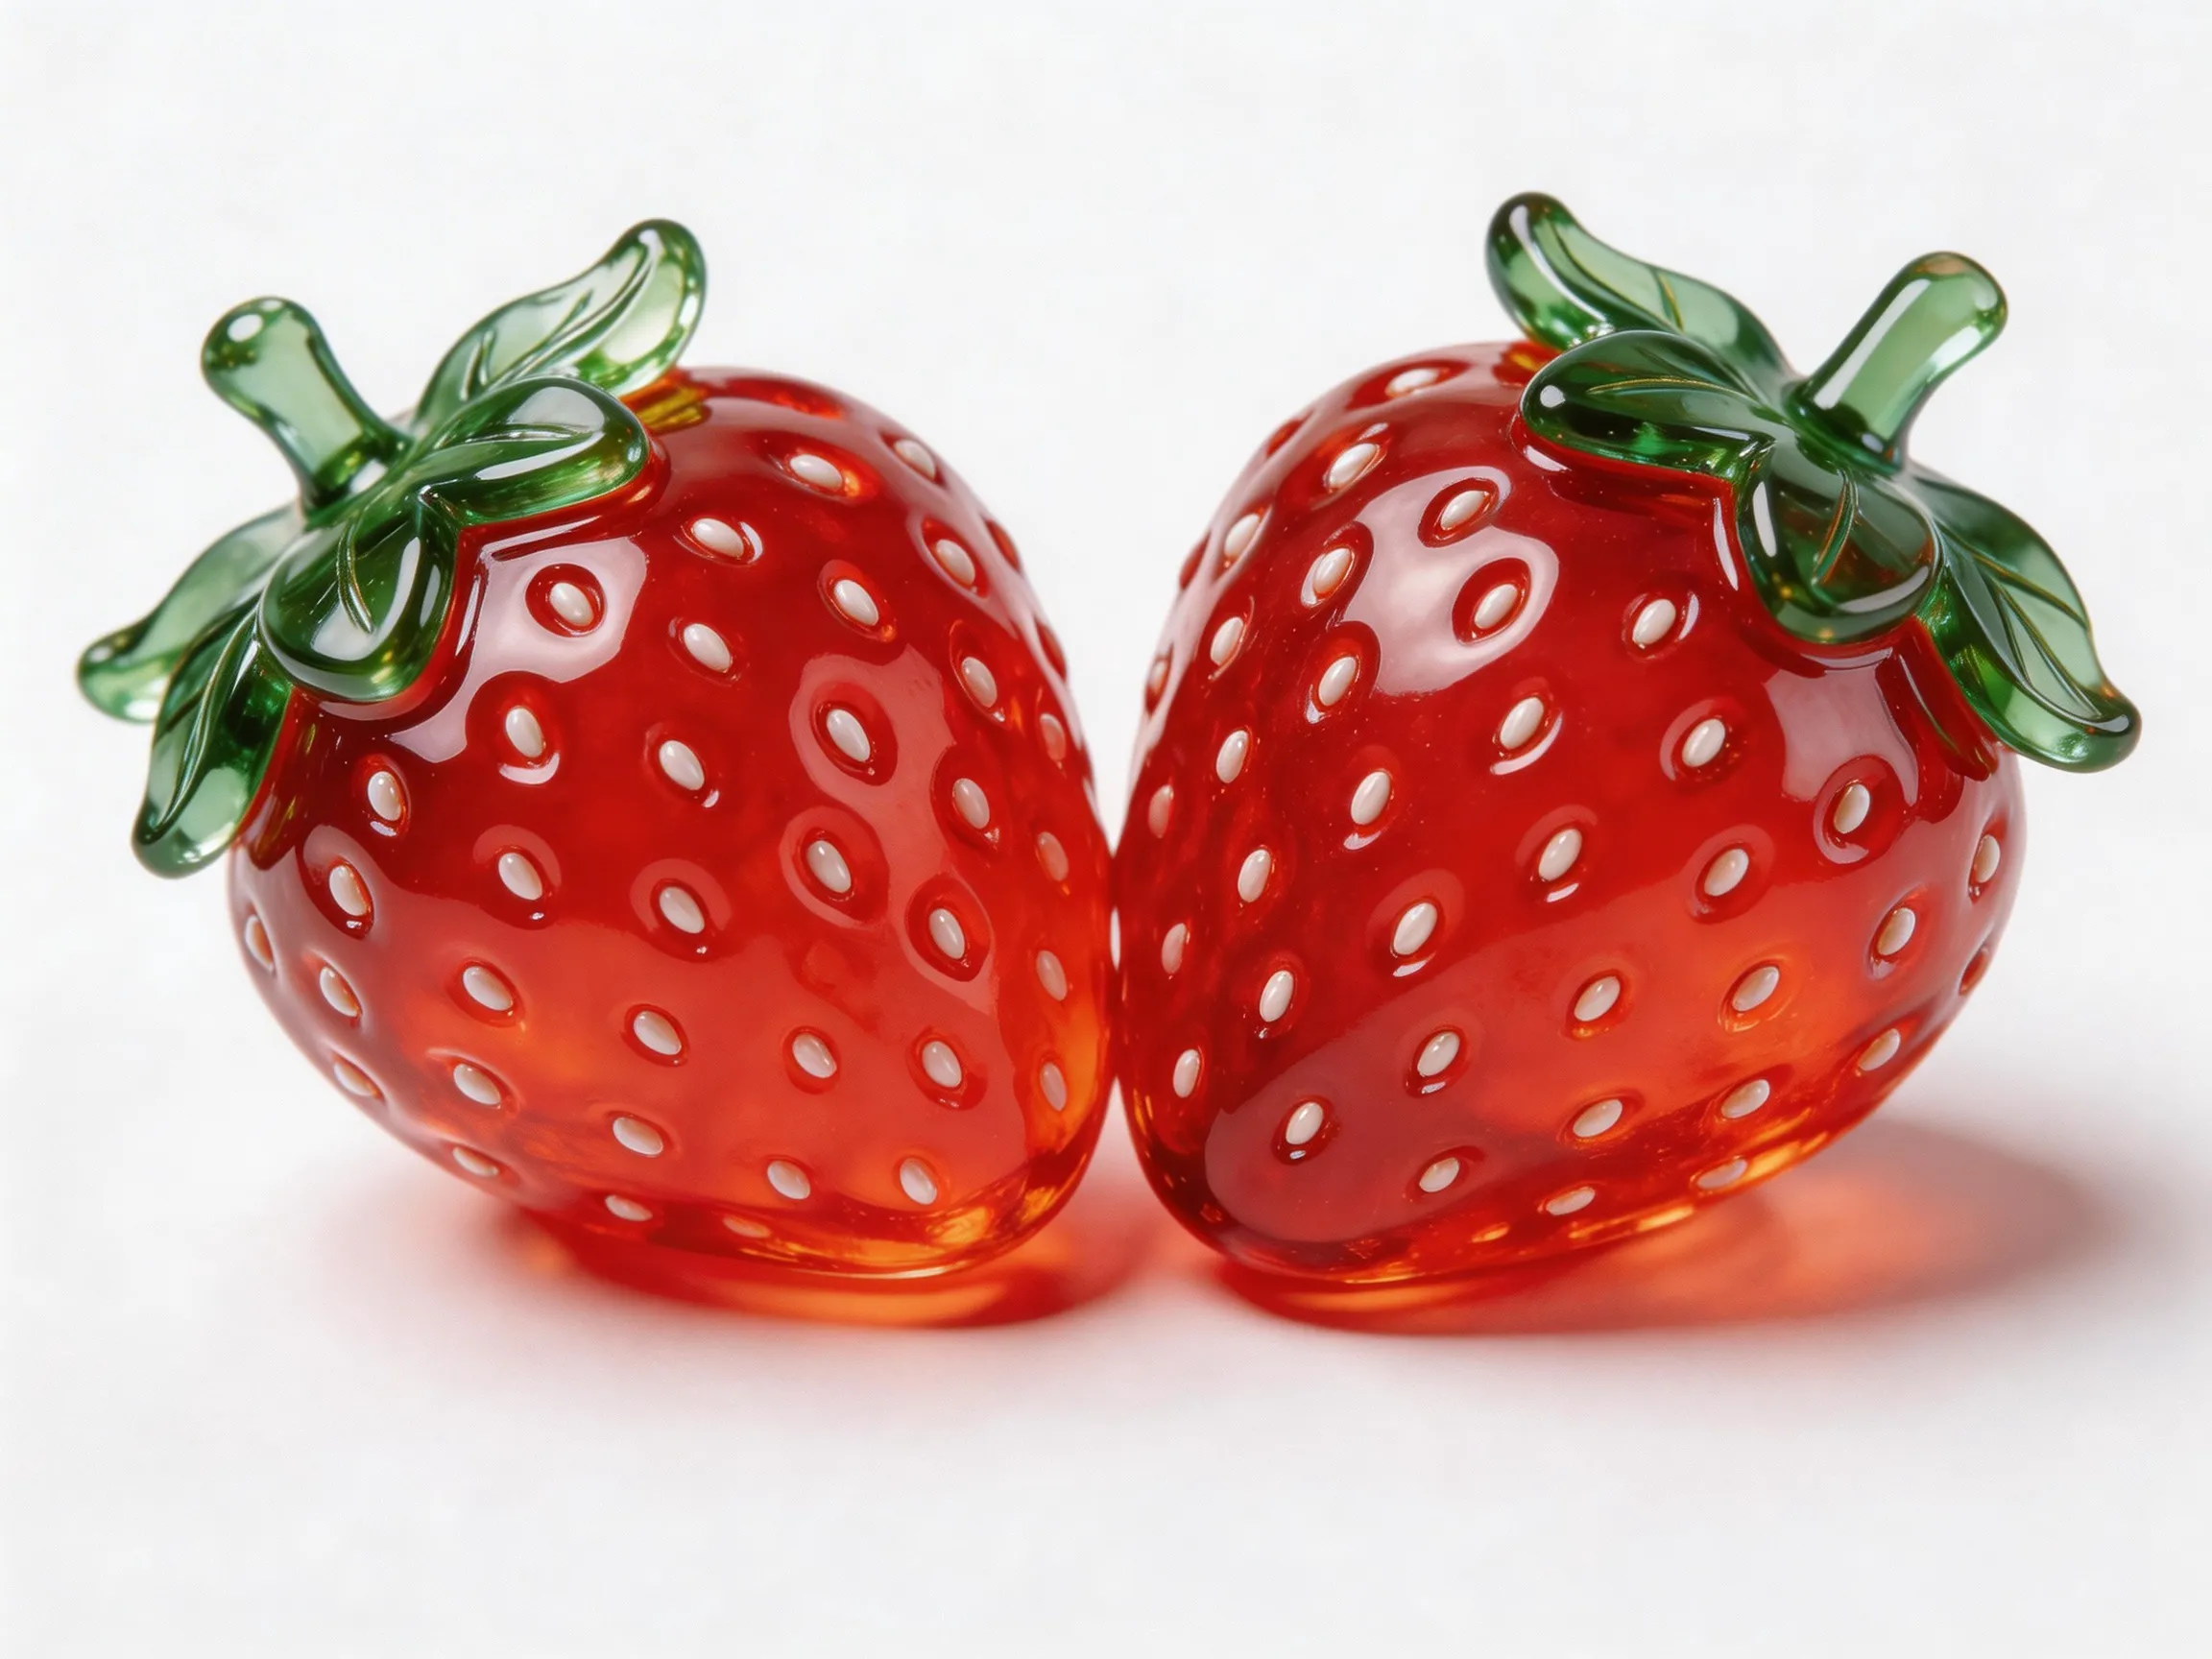
| 输入提示词:俯拍在一个蓝色的星球上,镜头逐渐推进到星球上面给到图1特写,他拿着图2,一边吃着图2,一边说:“怎么没人找我来玩呀?” | |||
输入首帧参考首帧 | 输入图像(图1)参考主体 | 输入图像(图2)参考物体 | 输出视频以首帧的宽高比生成视频 |
 |  |  | |
- Python SDK
- Java SDK
- curl
请确保 DashScope Python SDK 版本不低于 1.25.16,可参考安装SDK进行更新。
参数说明
wan2.7-r2v-2026-06-12
| 参数 | 类型 | 必选 | 说明 |
|---|---|---|---|
model | string | 是 | "wan2.7-r2v-2026-06-12" |
input.prompt | string | 是 | 最多 5,000 个字符。使用 Video 1/Image 1 按 media 数组中的顺序引用角色(图片和视频分开计数)。 |
input.media | array | 是 | 1-5 个元素。每个元素包含 type(reference_image、reference_video 或 first_frame)和 url。 |
input.negative_prompt | string | 否 | 最多 500 个字符。指定需要排除的内容。 |
input.reference_voice | string | 否 | 音频文件 URL(WAV/MP3 格式,1-10 秒,最大 15 MB),用于声音克隆。会覆盖参考视频中的音频。 |
parameters.resolution | string | 否 | "720P" 或 "1080P"(默认)。 |
parameters.ratio | string | 否 | "16:9"(默认)、"9:16"、"1:1"、"4:3"、"3:4"。提供 first_frame 时此参数被忽略。 |
parameters.duration | integer | 否 | 仅图片参考时为 2-15,包含视频参考时为 2-10。默认值:5。 |
parameters.prompt_extend | boolean | 否 | 通过 LLM 改写提示词。默认值:true。 |
parameters.watermark | boolean | 否 | 默认值:false。 |
parameters.seed | integer | 否 | 取值范围:0 到 2,147,483,647。 |
角色引用方式(wan2.7)
每个 media 元素根据其位置映射到一个角色标识符。图片和视频分开计数:
wan2.6 模型
| 参数 | 类型 | 必选 | 说明 |
|---|---|---|---|
model | string | 是 | "wan2.6-r2v-flash" 或 "wan2.6-r2v" |
input.prompt | string | 是 | 描述场景的文本提示词。按 reference_urls 中 URL 的顺序,使用 character1、character2 等引用角色。 |
input.reference_urls | array | 是 | 最多 5 个 URL,指向参考图片或视频。每个参考素材应包含单个角色。 |
parameters.size | string | 否 | 输出分辨率。例如 "1280*720"(16:9)。所有选项请参阅 API 参考。 |
parameters.duration | integer | 否 | 输出视频时长(秒)。 |
parameters.audio | boolean | 否 | true 生成有声视频,false 生成无声视频。默认值:true。仅 wan2.6-r2v-flash 支持无声视频。 |
parameters.shot_type | string | 否 | "multi" 多镜头切换,"single" 固定视角。 |
parameters.watermark | boolean | 否 | true 添加水印。 |
角色引用方式(wan2.6)
每个参考 URL 根据其在 reference_urls 数组中的位置映射到一个角色标识符:
输入视频计费规则
输入图像不计费,输入视频和输出视频按视频秒数计费:总计费时长(秒) = 输入视频计费时长(秒) + 输出视频时长(秒)。
输入视频计费时长上限为 5 秒:单个视频截断上限 = 5秒 ÷ 参考素材数量,每个视频按 min(实际时长, 截断上限) 计费,多个视频累加。wan2.7 只计参考视频(参考图像和首帧图像均不计入);wan2.6 计参考图像和参考视频(首帧图像不计入)。例如 wan2.7 输入 2 个参考视频时,每个视频按 2.5 秒截断。
多角色互动
最多支持五个角色同时出镜,实现自然对话和互动——适用于采访、对话、教程等场景。
支持的模型:wan2.6 系列模型。
以下示例使用 wan2.6 的 reference_urls 写法,在提示词中用 character1、character2 引用素材;wan2.7 的 media 数组与 Video N/Image N 写法见上文「核心能力」和下文「参数说明」。
将 shot_type 设为 multi 可实现动态多镜头切换,设为 single 则使用固定视角。
示例:四参考素材场景
提示词:"character2 sits on a chair by the window, holding character3, and plays a soothing American country folk song next to character4. character1 says to character2: 'that sounds great'"
character1(人物)视频
character2(人物)视频
character3(物体)图片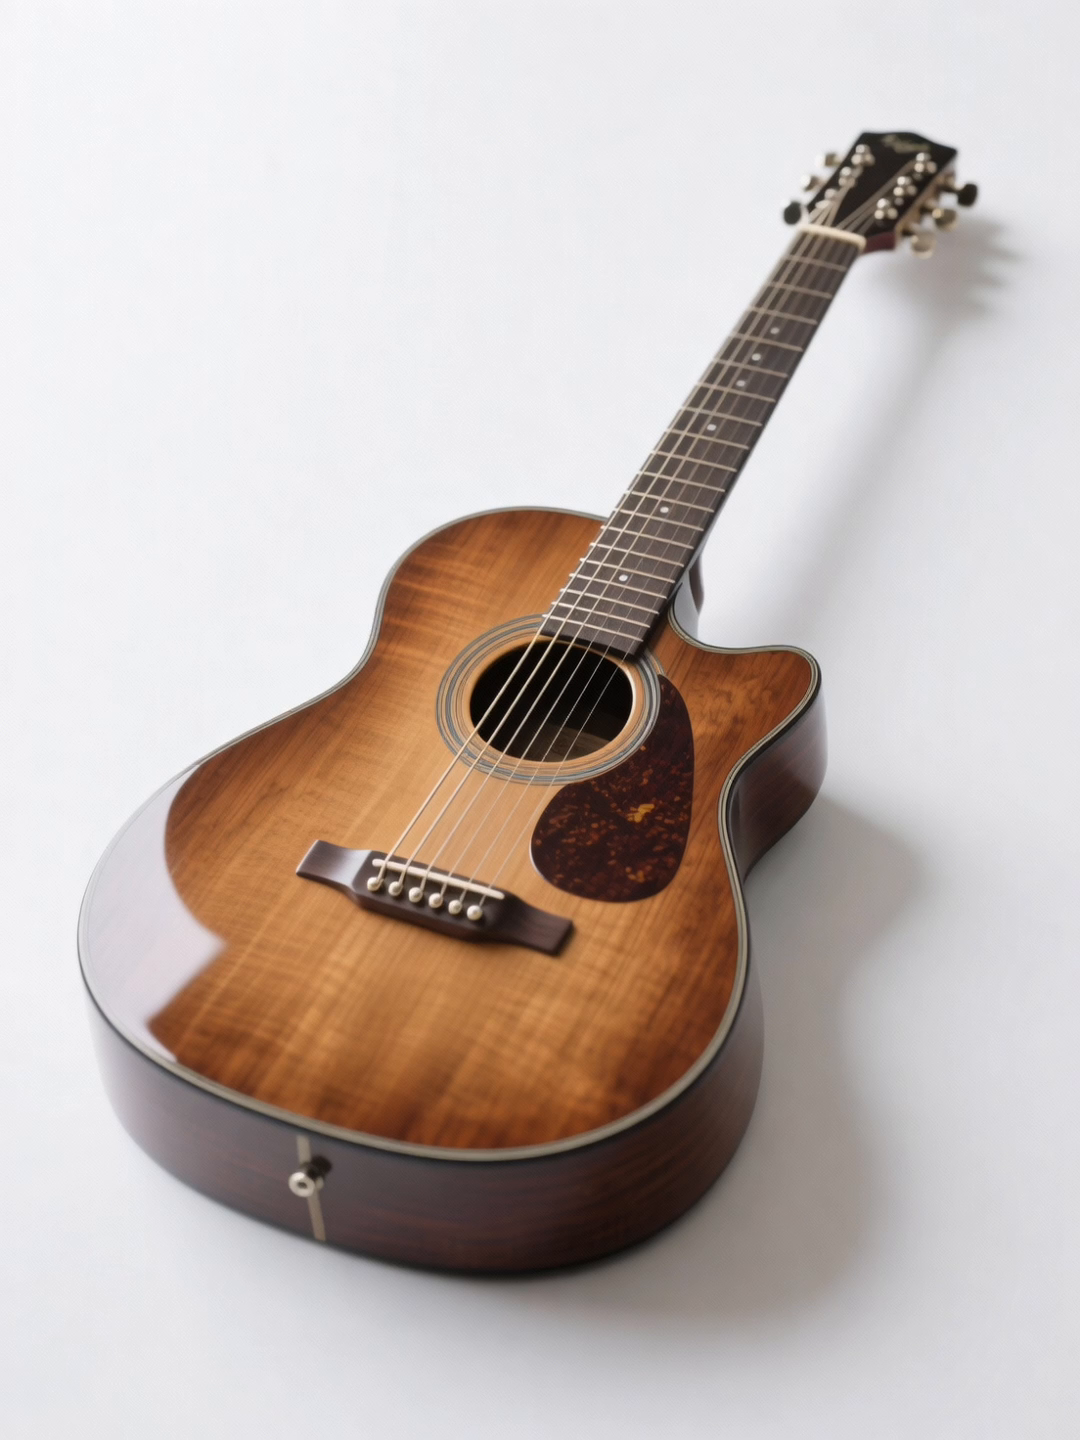
character4(背景)图片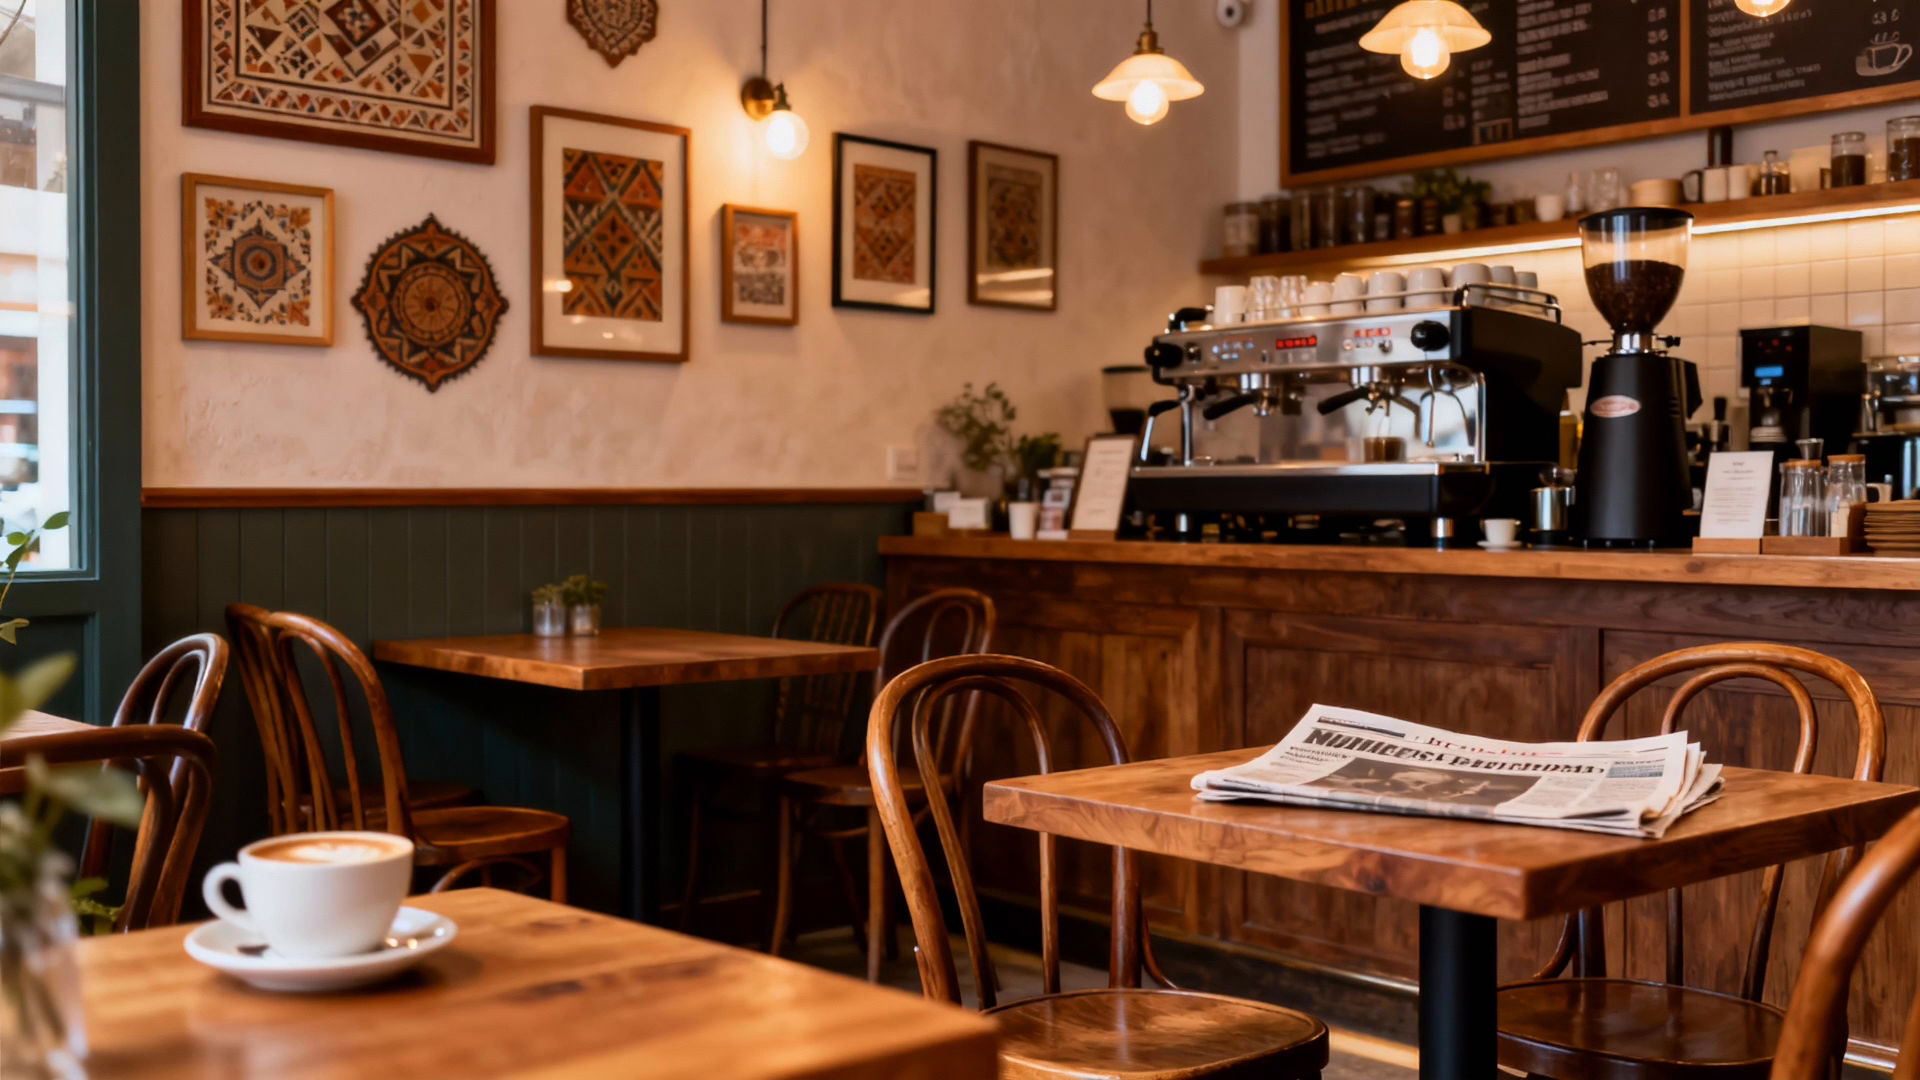
示例:双人对话
提示词:"character1 says to character2: 'I'll rely on you tomorrow morning!' character2 replies: 'You can count on me!'"
character1视频
character2视频
示例代码(curl)
所有示例均使用 X-DashScope-Async: enable 请求头提交异步任务。
第 1 步:提交任务
<task-id> 替换为第 1 步响应中的 task_id。
示例代码(Python)
以下示例提交一个多角色任务,并轮询直到获取结果。
单角色表演
从单个参考视频或图片创建跨场景的完整角色表演——适用于个人品牌、产品代言、培训教学等场景。
支持的模型:wan2.6 系列模型。
在 reference_urls 中传入单个 URL,并在提示词中使用 character1。建议将 shot_type 设为 multi。
示例:节日开箱视频
提示词:"Create a festive holiday unboxing experience. Shot 1 [0-2s]: Character1 sits by a beautifully decorated Christmas tree with twinkling lights, holding a wrapped gift box with elegant red and gold wrapping. Shot 2 [2-4s]: Close-up as Character1 carefully unwraps the gift, revealing premium skincare products inside. Shot 3 [4-6s]: Character1 applies the product with delight, saying: 'This holiday glow is exactly what I wanted!' Shot 4 [6-10s]: Character1 admires their radiant skin in a handheld mirror, surrounded by festive decorations, ending with a warm smile to camera."
character1视频
示例代码(curl)
第 1 步:提交任务
<task-id> 替换为第 1 步响应中的 task_id。
无声视频生成
创建不含音频的纯画面视频——适用于动态海报、无声短视频等场景。
支持的模型:仅 wan2.6-r2v-flash。
将 audio 设为 false。
示例:无声舞蹈视频
提示词:"character1 drinks bubble tea while dancing spontaneously to the music."
character1视频
示例代码(curl)
第 1 步:提交任务
<task-id> 替换为第 1 步响应中的 task_id。
如何输入参考素材
- wan2.7系列模型
参考图像、视频和音频均传入
media数组。输入图像
-
首帧数量:首帧(
media.type=first_frame)最多1张。 -
参考图像数量:参考图像(
media.type=reference_image)最多5张,同时满足参考图像 + 参考视频 ≤ 5。 -
输入方式:
- 公网URL:支持 HTTP 或 HTTPS 协议。示例:https://xxxx/xxx.png。
- 临时URL:支持OSS协议,必须通过上传文件获取临时 URL。示例:oss://dashscope-instant/xxx/xxx.png。
-
Base64 编码字符串:遵循
data:{MIME_type};base64,{base64_data}的格式,其中:- {base64_data}:图像文件经过 Base64 编码后的字符串。
-
{MIME_type}:图像的媒体类型,需与文件格式对应。
图像格式
MIME Type
JPEG
image/jpeg
JPG
image/jpeg
PNG
image/png
BMP
image/bmp
WEBP
image/webp

输入视频
-
参考视频数量:参考视频(
media.type=reference_video)最多5个,同时满足参考图像 + 参考视频 ≤ 5。 -
输入方式:
- 公网URL:支持 HTTP 或 HTTPS 协议。示例:https://xxxx/xxx.mp4。
- 临时URL:支持OSS协议,必须通过上传文件获取临时 URL。示例:oss://dashscope-instant/xxx/xxx.mp4。
输入音频
-
使用限制:参考音色(
media.reference_voice)只能与reference_image或reference_video搭配使用,为对应主体角色指定音色。 -
输入方式:
- 公网URL:支持 HTTP 或 HTTPS 协议。示例:https://xxxx/xxx.mp3。
- 临时URL:支持OSS协议,必须通过上传文件获取临时 URL。示例:oss://dashscope-instant/xxx/xxx.mp3。
输出视频
- 视频个数:1个。
- 视频规格:格式为MP4。详细规格请参见支持的模型。
- 视频URL有效期:24小时。
-
视频尺寸:
-
wan2.7系列模型:通过
resolution控制分辨率档位(720P/1080P),通过ratio控制宽高比(16:9、9:16、1:1、4:3、3:4)。- 传入首帧图像时:
ratio参数被忽略,输出视频的宽高比与首帧图像近似。 - 未传入首帧图像时:由
ratio参数指定宽高比,默认为 16:9。
- 传入首帧图像时:
-
wan2.7系列模型:通过
响应字段
| 字段 | 说明 |
|---|---|
output.task_id | 任务标识符,用于轮询状态。 |
output.task_status | PENDING、RUNNING、SUCCEEDED 或 FAILED。 |
output.video_url | 生成视频的 URL。task_status 为 SUCCEEDED 时可用。 |
output.orig_prompt | 原始输入提示词。 |
usage.duration | 输出视频时长(秒)。 |
usage.input_video_duration | 输入视频总时长(秒)。 |
usage.output_video_duration | 输出视频时长(秒)。 |
usage.video_count | 生成的视频数量(固定为 1)。 |
usage.audio | 输出视频是否包含音频。 |
usage.SR | 分辨率级别(720 或 1080)。 |
API 参考
常见问题
Q:如何在提示词中引用参考素材?
A:引用方式取决于所使用的模型和功能:
- wan2.7系列模型
- 参考图像通过“图1、图2”这类标识指代,参考视频通过“视频1、视频2”这类标识指代。英文提示词则写为“Image 1”、"Video 1”这类标识。
- 图和视频分别计数。顺序与
media数组中同类型素材的顺序一致。 - 若参考素材有且仅有一张图片或一个视频,可简化为“参考图片”或“参考视频”。
- 首帧图像通常无需在提示词中引用。
Q:reference_voice 可以与首帧图像搭配使用吗?
A:不推荐。media.reference_voice 推荐与 reference_image(参考图像)或 reference_video(参考视频)搭配使用,用于为对应主体指定音色。
如何设置视频宽高比?
wan2.7:使用 ratio 参数(16:9、9:16、1:1、4:3、3:4)。提供 first_frame 图片时,宽高比自动从图片推断。
wan2.6:使用 size 参数。每个分辨率对应固定的宽高比——例如 size=1280*720 生成 16:9 的视频。
如何在提示词中引用角色?
wan2.7:使用 Video N 或 Image N 标识符。图片和视频分开计数:
character1、character2 等——标识符与 reference_urls 中 URL 的顺序一一对应:
任务失败怎么办?
轮询任务状态接口。如果 task_status 为 FAILED,响应中的 message 字段会描述错误原因。常见原因包括无效的参考 URL、不支持的文件格式或超过限流。失败任务不计费。